Глобальные потери розницы от рассогласования запасов, слишком много одного товара и слишком мало другого, в 2026 году оцениваются примерно в 1,7 триллиона долларов, это около 6,2% всех розничных продаж в мире. Из этой суммы 65,6% приходится на дефицит товара, а 34,4% на избыток. За одной цифрой прячется системная проблема: прогноз продаж либо не считают вовсе, либо считают, но решения в компании принимают не по нему, а по интуиции и последнему разговору с клиентом.
Прогноз продаж считают на разных уровнях компании и с разными целями: коммерческий директор смотрит на выручку по месяцам, чтобы защитить бюджет, финансовый директор на ту же цифру, чтобы спланировать кассовые разрывы, а руководитель склада на прогноз по конкретным товарным позициям, чтобы вовремя заказать пополнение. Формально это один и тот же процесс, прогнозирование продаж, но на практике три разных человека часто считают его порознь, в разных таблицах и с разными допущениями, а потом удивляются, почему цифры на совещании не сходятся между собой.
Прогнозирование продаж и data-driven подход к решениям, это две стороны одной задачи, а не два разных проекта. Прогноз без привычки менять по нему закупки, бюджет и план остается красивой цифрой в таблице. Data-driven решения без нормального прогноза упираются в интуицию там, где интуиция как раз чаще всего ошибается, на горизонте в несколько месяцев вперед. В статье разберем методы прогноза от простых до сложных, посчитаем прогноз на цифрах, научимся оценивать его точность и разберемся, что нужно компании, чтобы прогноз реально влиял на решения, а не жил отдельно от них.
Что такое прогнозирование продаж и зачем оно бизнесу
Прогнозирование продаж — это процесс предсказания будущей выручки или объема продаж за конкретный период, неделю, месяц, квартал, на основе исторических данных, анализа рынка и статистических методов. Результат используют для планирования бюджета, найма, производства, закупок и стратегии продаж. Звучит просто, но здесь же прячется путаница, из-за которой прогнозы регулярно врут не потому, что метод плохой, а потому что за прогноз выдают совсем другую вещь.
Прогноз продаж и план продаж — это разные управленческие функции, а путать их — это самая частая методическая ошибка. Прогноз — это реалистичная оценка будущего спроса на основе данных: сколько компания продаст, если ничего не менять и рынок поведет себя так же, как раньше. План — это цель, которую компания намерена достичь: сколько компания хочет продать. План должен опираться на прогноз, отталкиваться от реалистичной картины, а не от желаемой цифры, но эти две вещи стоит считать и обсуждать раздельно. Когда прогноз незаметно подгоняют под план, чтобы цифры сходились на совещании, компания теряет единственный инструмент, который должен был предупредить ее о проблеме заранее, а не подтвердить то, что и так хотелось услышать.
Прогноз также различается по горизонту, и путать горизонты, вторая частая методическая ошибка после подмены прогноза планом. Краткосрочный прогноз на неделю-месяц опирается в основном на текущий пайплайн сделок и складские остатки и нужен для оперативных решений: сколько товара довезти на этой неделе, кого из менеджеров подключить к горящей сделке. Среднесрочный прогноз на квартал-полугодие учитывает уже сезонность и план продвижения и ложится в основу бюджета отдела. Долгосрочный прогноз на год и дальше опирается на тренд рынка, а не на конкретные сделки, которых на таком горизонте еще физически не существует в CRM, и годится для стратегических решений: открывать ли новый склад, нанимать ли отдел на новом направлении. Модель, которая точна на недельном горизонте, необязательно годится для годового прогноза, и наоборот, потому что на разных горизонтах решающую роль играют разные факторы.
Разница проявляется в конкретной ситуации, знакомой почти любому коммерческому директору. Отдел продаж защищает план на квартал, скажем 15 миллионов рублей, потому что такую цифру утвердили на стратегической сессии в начале года. Прогноз по факту текущей воронки и обычной сезонности показывает 11 миллионов. Если план и прогноз считает один и тот же человек под одним и тем же давлением, прогноз почти всегда подтянется к плану, а не наоборот, и руководитель узнает о реальном разрыве только по факту, когда квартал уже закрыт и почти ничего нельзя исправить. Разделить две функции, значит признать: прогноз может и должен показывать неприятную цифру, ниже плана, это не сбой в расчете, а сигнал заняться проблемой заранее, пока есть время скорректировать закупки, бюджет или воронку.
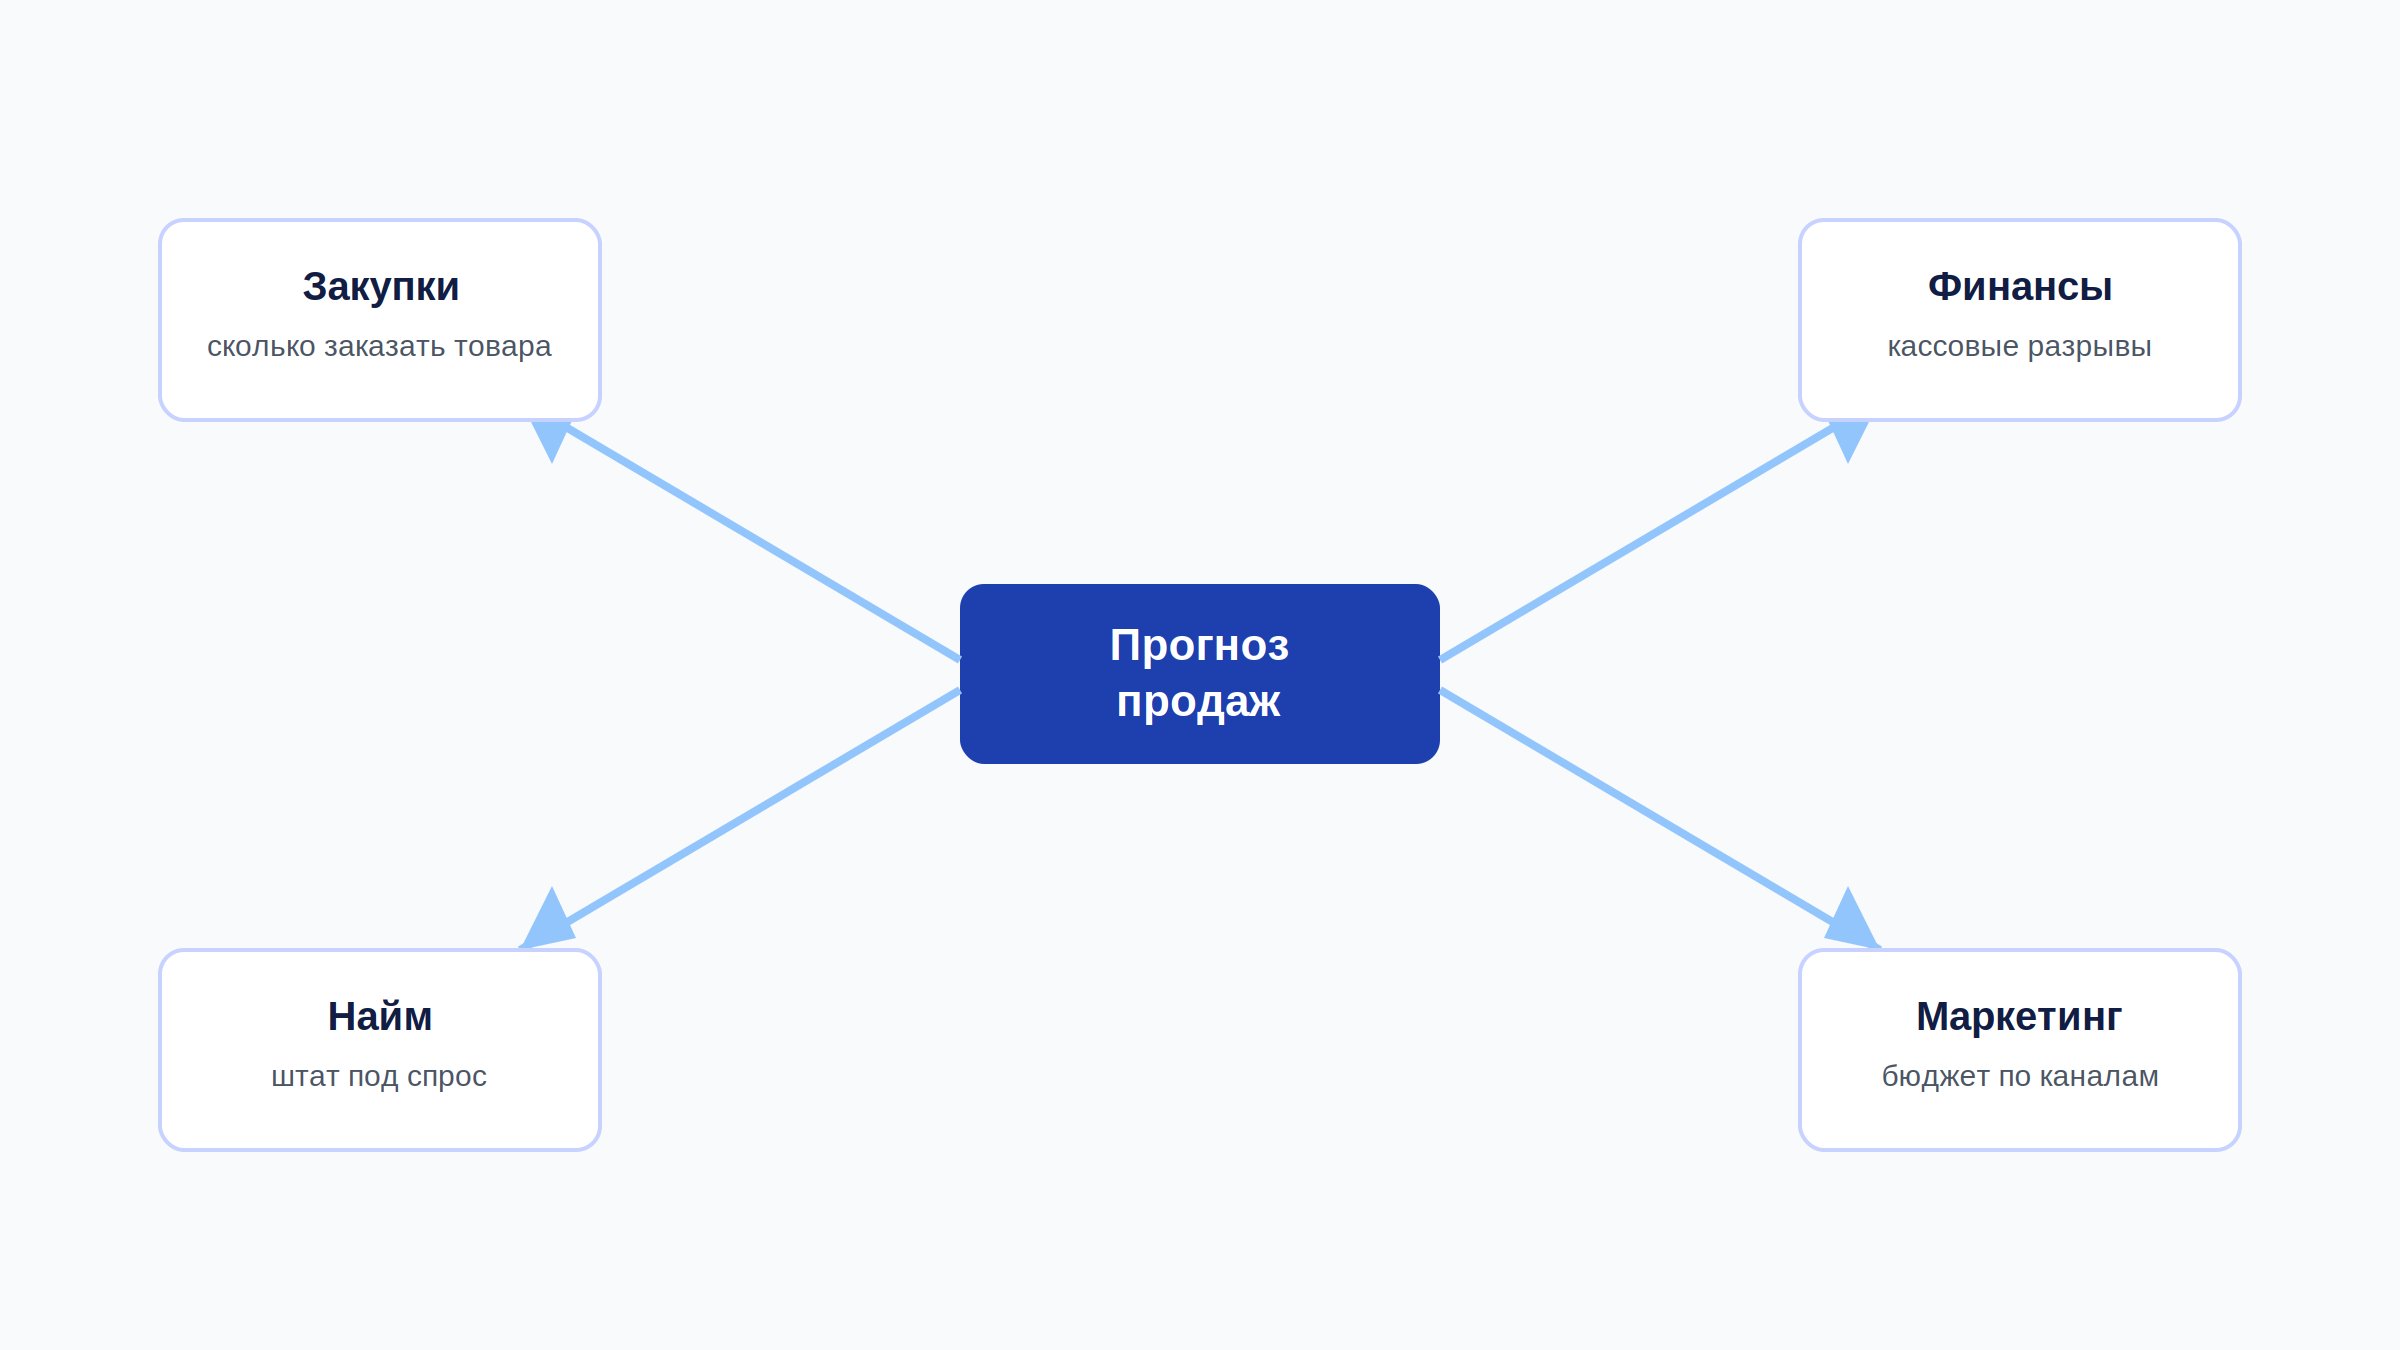
Зачем вообще нужен отдельный расчет, если можно просто поставить амбициозную цель и стремиться к ней. Прогноз влияет на решения в разных функциях компании одновременно, и без него каждая из них принимает решение вслепую, причем вслепую по-разному, в зависимости от того, какую именно ставку делает функция.
Закупки без прогноза заказывают либо слишком много товара, либо слишком мало, и оба варианта стоят денег: избыток замораживает капитал и площади склада, дефицит убивает продажи и отправляет клиента к конкуренту. Финансовый директор без прогноза не может спланировать кассовые разрывы: классический пример, сезонный товар закупают в октябре, а продают в декабре, и деньги на несколько месяцев зависают в запасах, а если параллельно нужно платить аренду и зарплату, разрыв между «деньги потрачены» и «деньги вернулись» может обернуться кассовым кризисом даже при растущем бизнесе с хорошими продажами.
Найм без прогноза работает в двух одинаково дорогих направлениях. Либо компания раздувает штат под ожидаемый рост, который не случился, и потом сокращает людей, либо не успевает нанять и обучить сотрудников под реальный всплеск спроса, и упускает продажи не из-за нехватки товара, а из-за нехватки рук, которые могли бы его продать. Маркетинг без прогноза действует по той же логике: либо перекладывает бюджет в канал, который уже выдыхается, либо опаздывает с усилением там, где спрос уже начал расти, и в обоих случаях деньги на рекламу тратятся не там, где от них была бы отдача.
Цена плохого прогноза не абстрактна, а измерима в деньгах. По исследованию Harvard Business Review 2004 года, дефицит товара на полке в среднем приводит к потере около 4% продаж, а 72% случаев дефицита связаны с ошибками пополнения запасов, не с внешним форс-мажором, а с тем, что заказ рассчитан неверно. По оценке отраслевых обзоров, компании с высокой точностью прогноза (80% и выше) фиксируют заметно более низкие расходы на срочные, аварийные закупки и растущую выручку, а компании с низкой точностью, ниже 60%, регулярно платят за срочные заказы и теряют выручку из-за постоянных сюрпризов с наличием товара. Разница между хорошим и плохим прогнозом видна не в отчете о методологии, а в счете за срочную логистику в конце месяца.
Похожая картина по цене ошибки видна и в других отраслевых оценках: дефицит товара обходится розничному бизнесу в 2-5% потерянной выручки, а избыточные запасы замораживают до 20-30% оборотного капитала компании, средств, которые могли бы работать, а вместо этого лежат на складе в виде нераспроданного товара. Обе цифры бьют по разным частям баланса, но источник один и тот же: прогноз, который разошелся с реальностью, и решение, которое было принято по нему заранее.
Переведем проценты в рубли на условном примере. Компания с годовой выручкой 200 миллионов рублей, у которой оборотный капитал в запасах составляет 40 миллионов, при избыточных запасах на уровне 25% фактически замораживает 10 миллионов рублей, которые могли бы пойти на маркетинг, найм или просто лежать на счете и не занимать кредитную линию. Дефицит на другом полюсе той же компании, 3% упущенной выручки при 200 миллионах оборота, это 6 миллионов рублей продаж, которые компания физически могла закрыть, но не закрыла, потому что нужного товара не было на складе в момент, когда его хотел купить клиент. Обе цифры не выдумка, а прямое следствие одной и той же управленческой привычки, закупать без расчета, а не по прогнозу.
Методы прогнозирования продаж
Методы прогнозирования делятся на две большие группы. Качественные методы опираются на экспертное суждение, а не на числовой анализ: консенсус руководства, метод Дельфи, когда несколько экспертов независимо дают оценку, а затем сверяют расхождения и уточняют мнение в несколько раундов, экспертные панели и опросы рынка. Их применяют, когда исторических данных недостаточно, например при запуске нового продукта, выходе на новый рынок или в период резких отраслевых сдвигов, когда прошлое плохо предсказывает будущее. Количественные методы опираются на исторические данные и статистические модели и работают лучше всего тогда, когда связи в данных стабильны, а сама история продаж достаточно длинная и надежная.
Метод Дельфи на практике выглядит скромнее, чем звучит его название. Компания, выходящая с новым продуктом, не может опереться на историю продаж, которой попросту еще нет, поэтому 5-7 экспертов, руководитель продаж, продакт, представитель маркетинга, независимо друг от друга дают письменную оценку ожидаемого спроса на первый квартал. Расхождения в оценках обсуждают и уточняют в два-три раунда, пока разброс не сузится до рабочего диапазона. Ценность метода не в точности отдельной оценки, а в том, что он делает разброс мнений видимым до запуска, а не после, когда цифра уже зашита в план закупок и бюджет.
На практике сильные компании редко выбирают между двумя группами методов, они комбинируют их. Статистическая модель считает базовый прогноз по истории продаж, а затем менеджер по продажам корректирует цифру экспертной поправкой: крупная сделка на подходе, которую модель не видит, потому что ее нет в истории, или, наоборот, ключевой клиент предупредил о паузе в закупках. Чисто статистический прогноз игнорирует такие разовые сигналы, чисто экспертный прогноз слишком легко подстраивается под желаемое. Комбинация из количественной базы и качественной поправки почти всегда точнее, чем любой из двух подходов по отдельности, именно поэтому крупные компании редко полагаются на одну модель без участия людей, которые держат руку на пульсе конкретных сделок.
Внутри количественных методов есть своя лестница от простого к сложному, и выбор метода определяется не модой, а объемом и характером доступных данных. Простое скользящее среднее берет среднее значение нескольких последних периодов и сглаживает случайные колебания. У метода есть жесткое ограничение: он полезен для прогноза только тогда, когда в данных нет выраженного тренда, при растущих или падающих продажах скользящее среднее систематически отстает от реальности, потому что усредняет вместе старые, еще невысокие цифры с новыми. Дальше в статье это видно на реальном расчете.
Экспоненциальное сглаживание решает часть этой проблемы: метод присваивает больший вес более свежим наблюдениям, но не отбрасывает старые данные полностью. Коэффициент сглаживания альфа, от 0 до 1, определяет, насколько быстро прогноз реагирует на последние изменения. Чем ближе альфа к единице, тем быстрее прогноз подстраивается под свежие цифры и тем более чувствителен к разовым скачкам, чем ближе к нулю, тем инерционнее и устойчивее к шуму. Метод легко считается в Excel и требует меньше исторических точек, чем регрессия, поэтому им часто пользуется малый и средний бизнес.
Линейная регрессия, трендовый анализ, оценивает долгосрочное направление ряда данных, рост или падение продаж во времени, и хорошо работает при достаточно длинной истории со стабильной, преимущественно линейной динамикой. Метод Хольта-Винтерса, тройное экспоненциальное сглаживание, идет дальше: он одновременно раскладывает ряд на три компонента, уровень, тренд и сезонность, каждый со своим коэффициентом сглаживания, и годится для рядов, где есть и рост, и сезонные пики одновременно, например продажи с всплеском в праздничные кварталы. За точность метод расплачивается требованиями к данным: нужно минимум два полных сезонных цикла истории, для годовой сезонности это два и более лет продаж.
Насколько заметно это может улучшить точность, показывает пример из одного научного сравнительного исследования: в конкретном датасете по категории «технологии» метод Хольта-Винтерса дал среднюю ошибку прогноза, MAPE, около 2,88%, заметно точнее простых методов на том же ряде данных. Цифра справедлива для одного исследования и одной категории, не как универсальный ориентир для любого бизнеса, но направление понятно: чем сложнее структура спроса, тренд плюс сезонность одновременно, тем больше выигрыш от метода, который явно моделирует обе составляющие, а не игнорирует одну из них.
ML и AI-модели прогнозирования идут еще на шаг дальше: они обучаются на исторических и внешних данных одновременно и способны учитывать сразу множество факторов, которые вручную свести в одну формулу практически невозможно. По оценкам отраслевых исследований, такие модели снижают ошибку прогноза на 20-50% по сравнению с традиционными методами и достигают точности 80-95% против медианной ошибки 25-50% при классических подходах в целом ряде отраслей. Такой подход оправдан для бизнеса с большим ассортиментом, множеством точек продаж и достаточной инфраструктурой для сбора данных в реальном времени, разбор того, как устроена сама BI-платформа под такими моделями, в статье про BI-систему.
Свести все методы в одну таблицу удобнее, чем читать про них по отдельности.
| Метод | Сложность | Когда применять | Минимум данных |
|---|---|---|---|
| Экспертная оценка | Низкая | Нет истории продаж, новый продукт или рынок | Не требуется |
| Скользящее среднее | Низкая | Стабильный спрос без выраженного тренда | 3-6 периодов |
| Экспоненциальное сглаживание | Низкая-средняя | Умеренные колебания без тренда и сезонности | 6-12 периодов |
| Линейная регрессия | Средняя | Устойчивый долгосрочный тренд | Несколько десятков периодов |
| Хольта-Винтерса | Высокая | Тренд и сезонность одновременно | 2+ полных сезонных цикла |
| ML и AI-прогноз | Высокая, нужна инфраструктура | Много факторов, SKU, каналов сразу | Большой объем истории и внешних данных |
Как рассчитать прогноз продаж на цифрах
Формулы выглядят абстрактно, пока не подставить в них реальные цифры. Возьмем условный магазин с помесячными продажами за год, от 820 тысяч рублей в январе до 1300 тысяч в декабре, и посчитаем прогноз двумя методами, чтобы увидеть их разницу не на словах, а на числах.
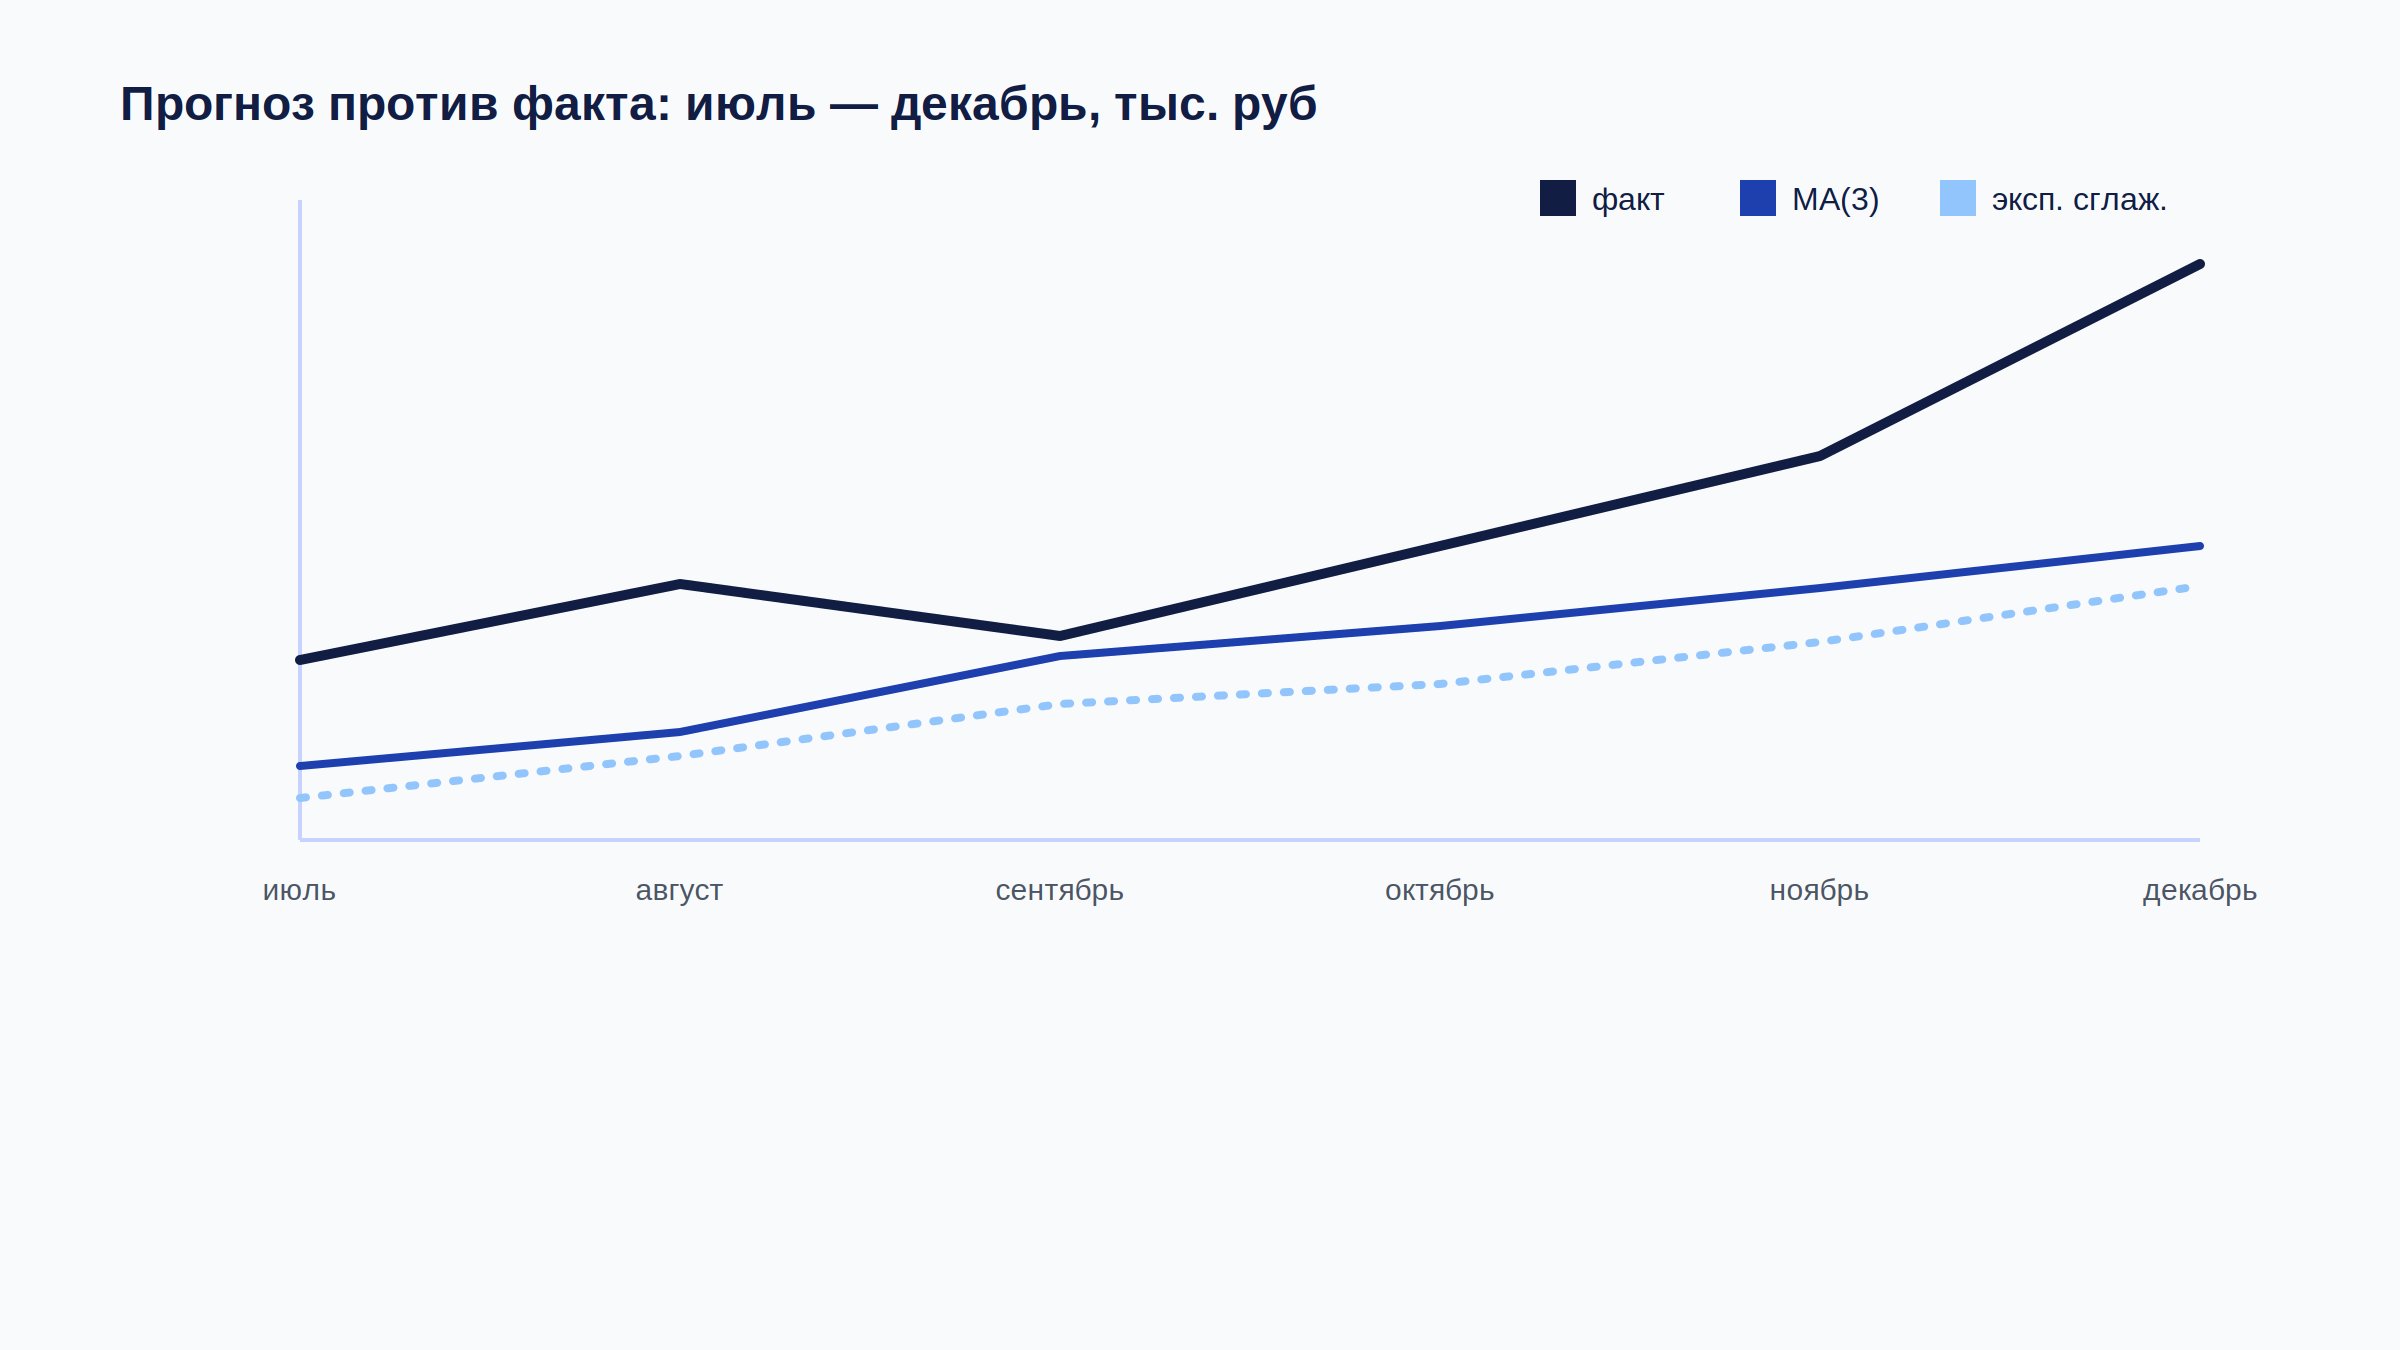
Скользящее среднее с окном в три месяца считается просто: сложить продажи за последние три месяца и разделить на три. Прогноз на апрель, по данным января, февраля и марта, 825 тысяч рублей, при факте 910 тысяч. Прогноз на декабрь, по данным сентября, октября и ноября, 1080 тысяч при факте 1300 тысяч. Разрыв между прогнозом и фактом растет от месяца к месяцу, и это не случайность, а прямое следствие растущего тренда продаж: скользящее среднее всегда тянется к более старым, более низким цифрам и системно отстает от растущего ряда, ровно то ограничение метода, о котором говорилось в разделе про методы.
Экспоненциальное сглаживание с коэффициентом альфа 0,3 реагирует на рост быстрее, но не устраняет отставание полностью. Прогноз на июль, 883 тысячи при факте 990. Прогноз на декабрь, 1048 тысяч при факте 1300. И скользящее среднее, и экспоненциальное сглаживание в этом примере недооценивают декабрьский всплеск, потому что ни один из двух методов не моделирует тренд явно, оба лишь по-разному усредняют прошлое. Для растущего ряда с трендом здесь подошла бы линейная регрессия или, если сверху есть еще и сезонность, метод Хольта-Винтерса из предыдущего раздела.
| Месяц | Факт, тыс. руб | MA(3) | Эксп. сглаживание (α=0,3) |
|---|---|---|---|
| Июль | 990 | 908,3 | 883,2 |
| Август | 1050 | 935,0 | 915,2 |
| Сентябрь | 1010 | 993,3 | 955,6 |
| Октябрь | 1080 | 1016,7 | 971,9 |
| Ноябрь | 1150 | 1046,7 | 1004,3 |
| Декабрь | 1300 | 1080,0 | 1048,0 |
Из таблицы видно закономерность, которая важнее конкретных цифр: чем ближе к декабрю, тем сильнее оба прогноза отстают от факта, и отставание растет, а не остается постоянным. Это не ошибка расчета, а математическое свойство методов, которые по определению строятся на прошлых значениях: пока продажи растут месяц за месяцем, прошлое всегда немного ниже, чем настоящее, и любой метод, который усредняет прошлое, унаследует это отставание. Разница между MA(3) и экспоненциальным сглаживанием в скорости реакции: сглаживание с альфа 0,3 отстает чуть меньше, потому что сильнее взвешивает последний месяц, но принципиально ту же проблему решает только метод, у которого тренд явно заложен в формулу.
Сезонность в простых методах учитывают отдельным коэффициентом, сезонным индексом. Для каждого сезонного периода считают отношение фактического значения к скользящему среднему ряда, которое сглаживает и тренд, и сезонность одновременно, затем усредняют эти отношения по всем годам истории для одного и того же периода, например для всех декабрей. Индекс выше единицы означает, что период продает лучше среднего, ниже единицы, хуже среднего, и это единственное число потом умножают на прогноз тренда, чтобы получить итоговую цифру с поправкой на сезон.
В примере с условным магазином квартальные индексы получаются такими: первый квартал 0,84 от среднего года, второй 0,93, третий 1,04, четвертый 1,20. Прочитать эти четыре цифры можно как готовую управленческую подсказку: продажи четвертого квартала в среднем на 20% выше обычного месяца, а первого квартала на 16% ниже, и это стоит учитывать в закупках и штатном расписании задолго до самого сезона, а не по факту, когда склад уже не успевает пополниться. Итоговый прогноз с учетом сезонности — это прогноз тренда, умноженный на соответствующий сезонный индекс: если базовый тренд без поправки на сезонность дает на четвертый квартал 1000 тысяч рублей, с индексом 1,20 прогноз становится 1200 тысяч, а без этой поправки компания рисковала бы прийти в декабрь с запасами, рассчитанными на обычный месяц.
Прогнозирование спроса и продаж по товарам
Все, что было выше, работает на уровне общей выручки компании. Но у товарного бизнеса есть отдельная и более коварная задача, прогноз спроса по конкретным товарным позициям, SKU, а не по обороту в целом. Агрегированный прогноз выручки может быть точным в сумме и одновременно сильно ошибочным для отдельных товаров внутри этой суммы, потому что ошибки в разные стороны, перепрогноз одних позиций и недопрогноз других, взаимно гасят друг друга в общем итоге.
Механика проста: запасы закупают, производят и отгружают по конкретному товару и точке хранения, а не по категории целиком. Прогноз, который точен на уровне категории, но ошибается на уровне отдельных SKU, все равно приводит к дефициту по быстро продающимся позициям и избытку по медленным, даже когда верхнеуровневая цифра в отчете выглядит правильной. Представим категорию из трех товарных позиций с суммарным прогнозом продаж 300 единиц в месяц. Если прогноз ошибся ровно наоборот по двум позициям, недооценил одну на 40 единиц и настолько же переоценил другую, категория в отчете покажет нулевую ошибку, хотя по одной позиции склад пуст, а по другой затоварен, и обе ситуации одинаково стоят компании денег.
Второй источник ошибок на уровне SKU, товары внутри одной категории конкурируют за одного и того же покупателя, а не продаются независимо друг от друга. Когда на складе кончается любимый размер или цвет, часть покупателей не уходит вообще, а берет соседнюю позицию из той же категории, и это смещает спрос на нее вверх без реальной причины в виде роста интереса к товару. Модель, которая считает каждый SKU полностью независимо от соседних, рискует принять эффект замещения за настоящий рост спроса и в следующем периоде заказать больше товара, который на самом деле не стал популярнее, а просто оказался под рукой у покупателей, не нашедших то, за чем пришли.
Товарный прогноз дополнительно осложняют промо-акции: изменения цены создают нерегулярные скачки спроса, которые классические модели, построенные на исторических средних, плохо улавливают, потому что эффект промо зависит от глубины скидки, сроков и категории товара, и единого коэффициента промо-подъема для всех случаев не существует. Удачная промо-акция способна опустошить полку и привести к упущенным продажам, если запас заранее не был рассчитан на этот всплеск, а неудачная, наоборот, оставляет склад забитым нераспроданным товаром по сниженной цене. По данным одной научной публикации, регрессионные модели, которые явно учитывают признаки промо-периода, тип акции, глубину скидки, рекламную поддержку, заметно точнее в такие периоды, чем модели, которые просто опираются на средние значения прошлых продаж без поправки на акцию.
Когда товарный прогноз неточен, бизнес либо закупает слишком много конкретного товара, либо слишком мало. Избыточные запасы замораживают капитал и увеличивают расходы на хранение, а дефицит ключевых позиций ведет к упущенным продажам и клиентам, которые уходят к конкуренту и не всегда возвращаются. Без прогноза на уровне конкретной позиции компания не видит момент, когда продажи по товару замедляются, и продолжает заказывать столько же, сколько заказывала в лучшие месяцы, вместо того чтобы вовремя сократить объем закупки.
На практике это выглядит так: интернет-магазин посуды прогнозирует категорию «сковороды» на 500 единиц в месяц и попадает в цифру почти точно, 498 фактических продаж. Отчет по категории выглядит идеально. Но внутри категории 40 SKU, и прогноз по самой ходовой позиции, сковорода 24 см с антипригарным покрытием, был занижен на 60 единиц, а по медленной позиции, редкий размер 32 см с крышкой, завышен ровно на столько же. Результат: склад пуст по товару, который реально покупают, и забит товаром, который стоит месяцами, хотя сводный отчет по категории не покажет ни единой причины разобраться, потому что на уровне категории ошибка математически исчезла.
Связь с логистикой здесь прямая, а не абстрактная. Отдел закупок формирует заказ поставщику на несколько недель или месяцев вперед, и если прогноз по конкретной позиции устарел, заказ едет по инерции: столько же коробок, сколько заказывали в прошлый раз, независимо от того, что реальный спрос на эту позицию уже сместился. Товарный прогноз, обновляемый регулярно, а не раз в квартал вместе с общим бюджетом, позволяет скорректировать заказ до того, как он превратится в лишнюю фуру на складе или в пустую полку, а не после, когда деньги уже потрачены и исправить решение может только уценка или срочная допоставка по завышенной цене.
Как оценить точность прогноза и не обмануть себя
Посчитать прогноз, это только половина задачи, вторая половина, регулярно проверять, насколько он был прав, и не путать точность прогноза с приятным самоощущением от красивого расчета. Для этого есть три базовые метрики, и у каждой свое назначение.
MAE, средняя абсолютная ошибка, показывает средний размер ошибки в тех же единицах, что и сами данные, рублях или штуках. Формула простая: сложить абсолютные разности между фактом и прогнозом за все периоды и разделить на число периодов. В примере из раздела про расчет, для экспоненциального сглаживания на последних шести месяцах, MAE получился 133,6 тысячи рублей. Метрика хорошо подходит для сравнения разных моделей прогноза на одном и том же товаре, но плохо годится для сравнения точности между товарами разного масштаба продаж: ошибка в 10 штук критична для позиции с продажами 20 штук в месяц и незаметна для позиции с продажами 2000 штук.
MAPE, средняя абсолютная процентная ошибка, решает эту проблему масштаба: та же логика, но в процентах от факта, а не в натуральных единицах. В том же примере MAPE вышел 11,8%. Метрика не зависит от масштаба и подходит для сравнения точности между разными товарами и категориями. У нее есть ограничение: при факте, равном нулю, метрика не считается, а для товаров с низкими продажами MAPE может давать искусственно завышенные, вводящие в заблуждение значения ошибки, скажем один непроданный экземпляр редкого товара при прогнозе в два уже дает ошибку 50%, хотя в деньгах это почти незаметная сумма.
Универсального порога хорошего MAPE не существует, ориентир сильно зависит от отрасли, волатильности спроса и того, насколько вообще предсказуем конкретный бизнес. По одной из отраслевых оценок диапазоны выглядят так.
| Отрасль | Типичный MAPE |
|---|---|
| Высокопредсказуемый спрос | ниже 10%, отличный результат |
| Товары повседневного спроса | 15-25% |
| Производство | 20-40% |
| Одежда и розница | часто выше 30% |
Практический вывод из этой таблицы не в том, чтобы стремиться к единому идеалу, а в том, чтобы сравнивать свою точность с реалистичным ориентиром своей отрасли, а не с абстрактной цифрой из чужого бизнеса. Компания в моде с MAPE 25% может работать лучше среднего по своей волатильной отрасли, а завод с тем же MAPE 25% почти наверняка недорабатывает: у производства спрос обычно стабильнее и предсказуемее, чем у продавца одежды с сезонными коллекциями.
Третья метрика, смещение прогноза, bias, показывает не размер ошибки, а ее направление, систематически ли прогноз занижен или завышен. В примере из расчета среднее отношение факта к прогнозу составило 113,7%, то есть модель систематически недооценивала продажи, логичное следствие того, что оба метода отставали от растущего тренда. Смещение важно считать отдельно от MAE и MAPE, потому что плюсовые и минусовые ошибки могут гасить друг друга в этих метриках, а bias фиксирует именно накопленный перекос в одну сторону, даже небольшое смещение, повторяясь месяц за месяцем, превращается в системную проблему запасов.
| Метрика | Что показывает | Единицы | Когда использовать |
|---|---|---|---|
| MAE | Средний размер ошибки | Натуральные (руб, шт) | Сравнение моделей на одном товаре |
| MAPE | Средний размер ошибки | Проценты от факта | Сравнение между товарами разного масштаба |
| Bias | Направление ошибки | Проценты | Поиск системного перекоса прогноза |
Отдельно стоит держать в голове контринтуитивную вещь: прогноз со стопроцентной точностью задним числом, это не повод для гордости, а повод для проверки. Кажется естественным, что чем точнее модель совпадает с историей, тем она лучше. Проверка по данным показывает обратное: идеальное совпадение с прошлым почти всегда можно получить, если у модели достаточно параметров для подгонки под каждую точку, а такая подгонка называется переобучением и так же плохо для будущего прогноза, как неспособность уловить в данных системную закономерность вообще.
Единственный надежный способ проверить, не переобучена ли модель, это оценивать точность на данных, которые не участвовали в ее построении. История делится на обучающую и тестовую часть: параметры модели подбирают на обучающей, а ошибку считают только на тестовой, которую модель раньше не видела. Если точность на тестовых данных заметно хуже, чем на обучающих, это верный признак переобучения, а не повод радоваться красивому графику на исторических цифрах.
Как часто пересматривать сам прогноз, отдельный вопрос, и универсального стандарта здесь тоже нет. Частота зависит от волатильности бизнеса и от того, насколько быстро решения на основе прогноза устаревают. Чисто квартальный пересмотр почти всегда слишком редкий: воронка сделок и спрос меняются быстрее, чем раз в три месяца, и компания рискует узнать о проблеме тогда, когда исправлять ее уже поздно. Рабочий ориентир, который использует часть компаний, многоуровневый: короткие еженедельные проверки на уровне отдельных сделок или SKU, чтобы ловить изменения рано, ежемесячный пересмотр цифры для руководства и более редкая сверка накопленной точности, MAE, MAPE, смещения, чтобы понять, не деградирует ли модель со временем. Разбор того, как эти метрики точности превращаются в конкретные управленческие цифры, KPI и OKR отдела, в статье про постановку KPI.
Типичные ошибки прогнозирования продаж
Даже с правильными формулами прогноз регулярно расходится с реальностью из-за нескольких повторяющихся ошибок, которые встречаются у компаний независимо от отрасли и размера.
- Прогноз незаметно подменяют планом. Вместо честного расчета от данных цифру подгоняют под желаемый результат или коммерческое давление сверху, и прогноз перестает выполнять свою единственную функцию, предупреждать о разрыве между желаемым и реальным заранее.
- Точность прогноза меряют только по среднему, без учета сегментов. Перепрогноз на 1000 единиц в одном регионе и недопрогноз на 1000 единиц в другом дают в сумме национальный отчет с нулевой ошибкой, при этом на практике склад в одном регионе переполнен, а полки в другом пустуют. Метрики точности нужно считать на том уровне, где реально принимаются решения, по товару, каналу, региону, а не только на верхнеуровневом агрегате.
- Модель игнорирует сезонность. Без учета сезонных колебаний компания рискует столкнуться с дефицитом в пиковые периоды и избыточными запасами в периоды затишья, притом что сезонный индекс из раздела про расчет закрывает эту проблему буквально одной дополнительной формулой.
- Прогноз не пересматривают, когда меняются входные данные. Паттерны спроса со временем меняются, и модель, которую никто не перекалибровывает под новые данные, продолжает опираться на условия, которых уже нет, даже когда реальные продажи явно расходятся с прогнозом.
- Прогноз считают в отрыве от воронки продаж и текущего пайплайна сделок. Когда менеджеры вовремя не обновляют статус сделок, в прогнозе накапливается фантомный пайплайн, сделки, которые фактически мертвы месяцами, но продолжают числиться и завышать ожидаемую выручку.
- За точность прогноза формально никто не отвечает. Модель считает аналитик, решение по ней принимает коммерческий директор, а закупку делает отдел снабжения, и когда прогноз расходится с фактом, каждый из трех считает виноватым кого-то из остальных двух, вместо того чтобы разобрать конкретную ошибку и исправить процесс на будущий период.
- Прогноз путают между единицами и деньгами. Рост продаж на 10% в штуках и рост на 10% в выручке, разные цифры, если за период менялась цена, ассортиментный микс или доля скидок, и решение, принятое по одной цифре вместо другой, дает системно неверный вывод о том, что на самом деле происходит со спросом.
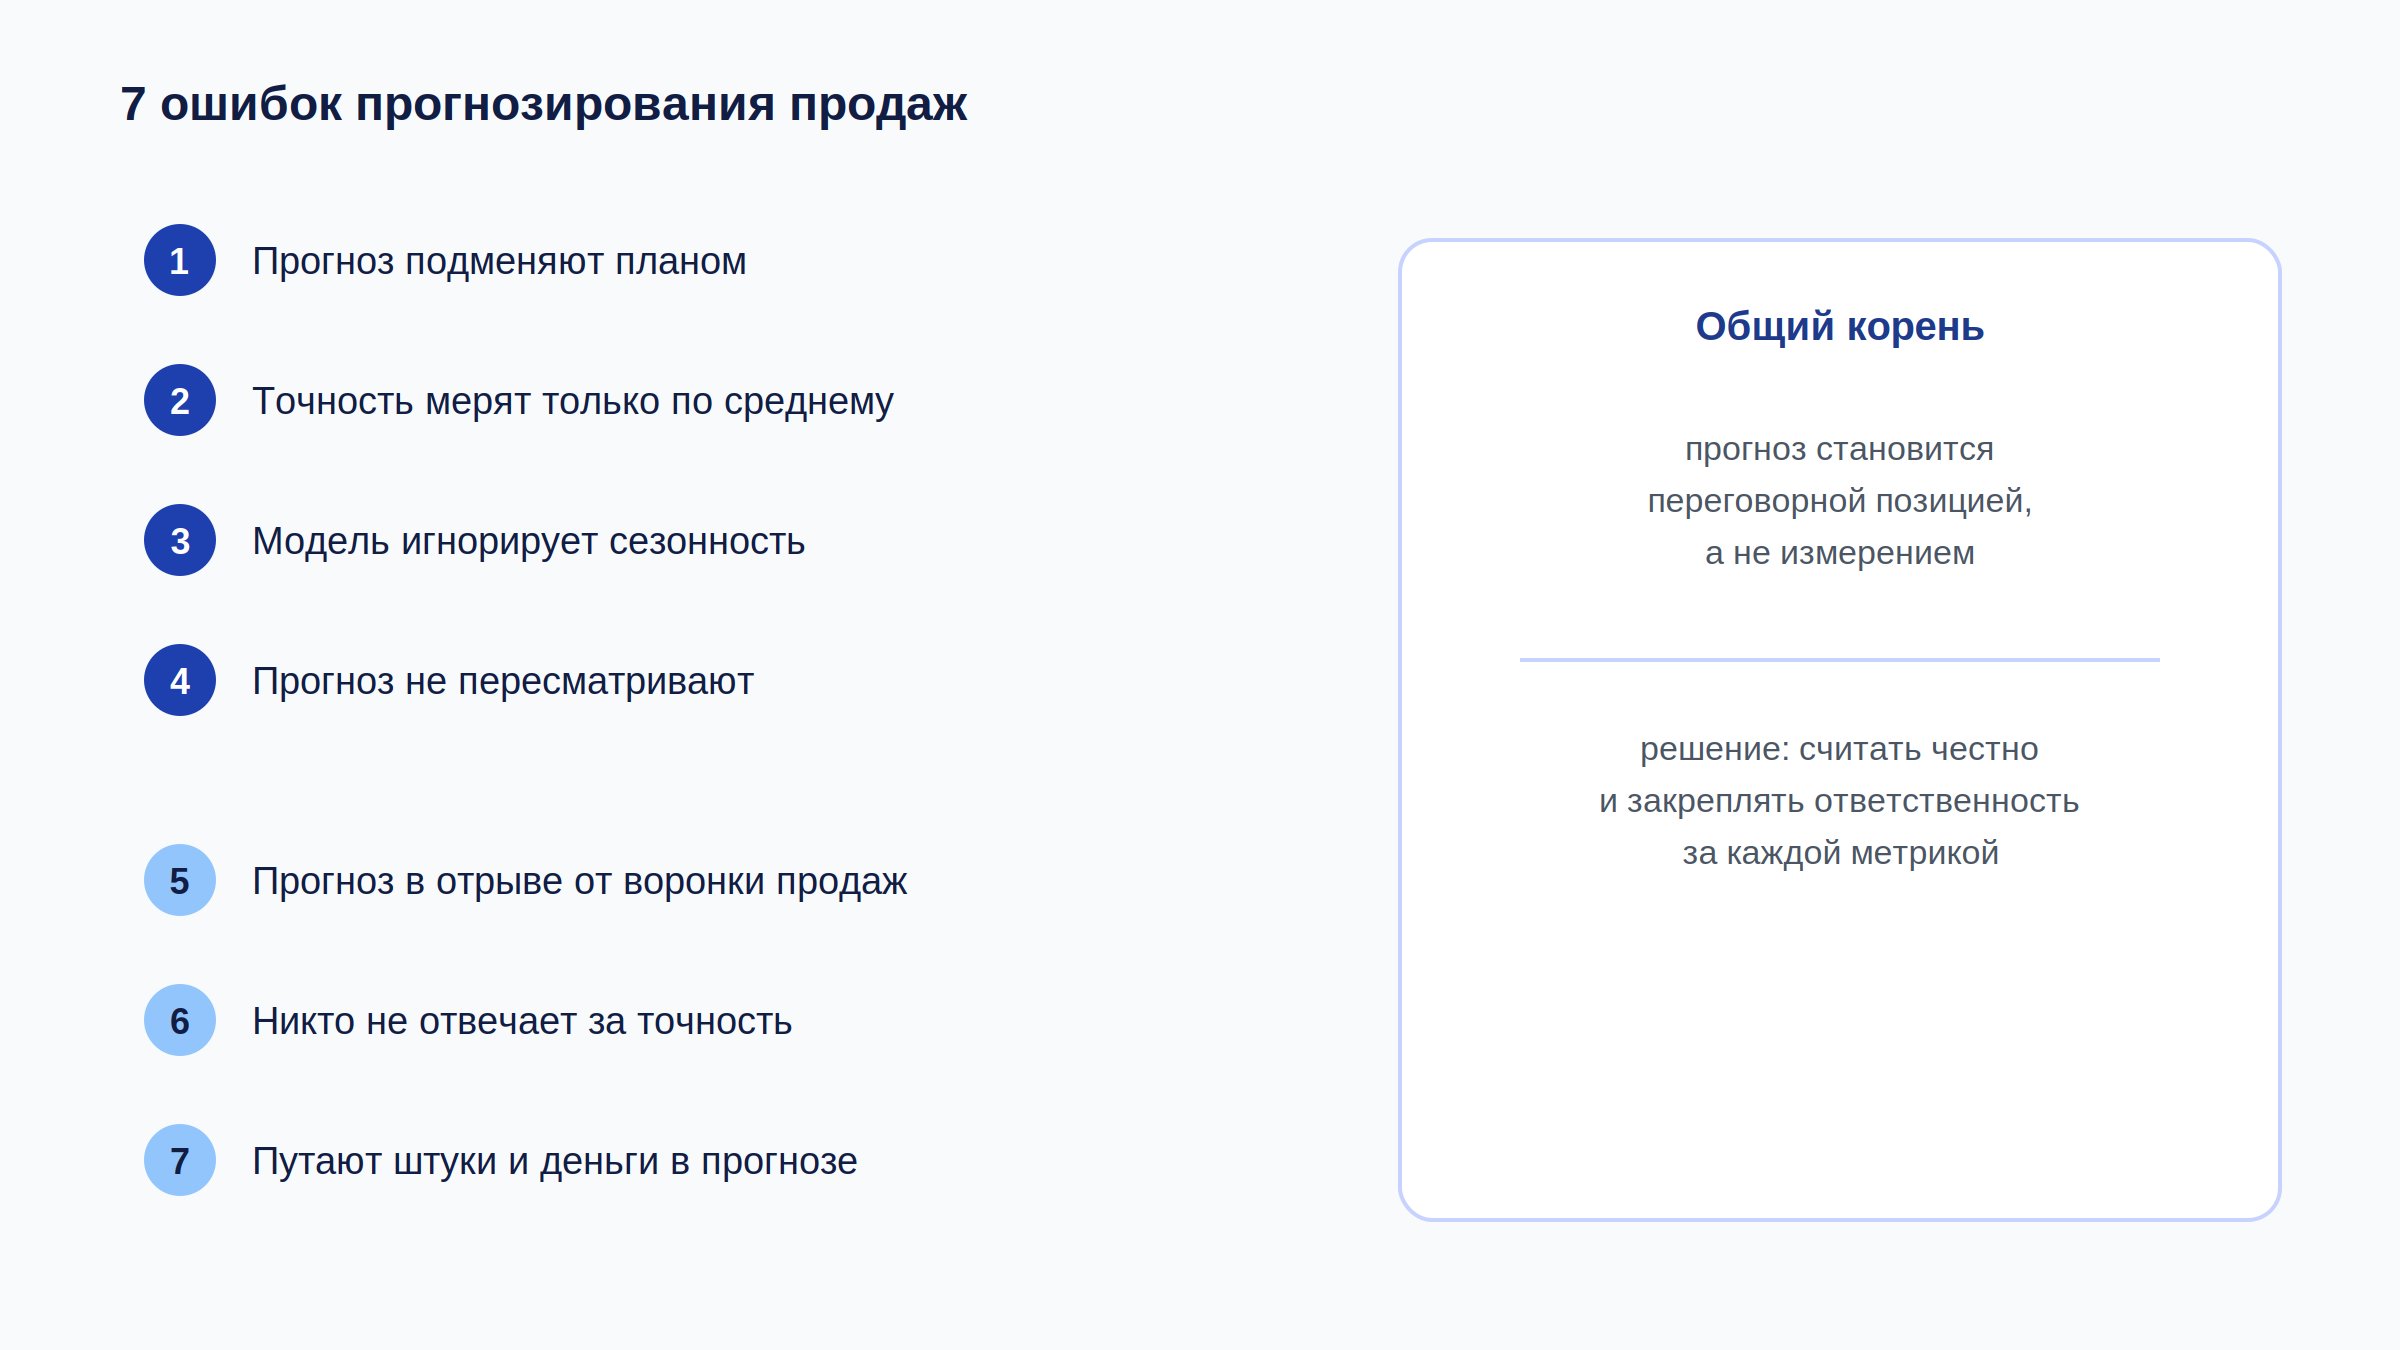
За большинством этих ошибок стоит одна и та же логика: прогноз перестает быть измерением и превращается в переговорную позицию. Как только цифру начинают подстраивать под чьи-то ожидания, вместо того чтобы честно считать ее от данных, метод расчета уже не имеет значения, сколько бы формул за ним ни стояло. Показательно, что большая часть ошибок вообще не про формулы: путаница с планом, игнорирование сегментов, отрыв от воронки и отсутствие ответственного за метрику решаются организационно, привычкой считать честно и закреплять ответственность, а не покупкой более сложной модели прогноза.
Признак того, что компания уже наступила на одну из этих граблей, обычно виден раньше, чем кажется. Если прогноз каждый месяц оказывается почти точно равен плану, а не колеблется вместе с реальными данными, это не признак отличного расчета, а признак того, что прогноз давно не считают, а переписывают под план. Настоящий прогноз, построенный от данных, будет иногда показывать цифру ниже плана, иногда выше, потому что реальный спрос не обязан совпадать с тем, что компания хочет продать в конкретном квартале. Подробнее о том, как воронка продаж и пайплайн сделок связаны с прогнозом на практике, в статье про аналитику воронки продаж.
Какими инструментами считать прогноз: от таблиц до BI
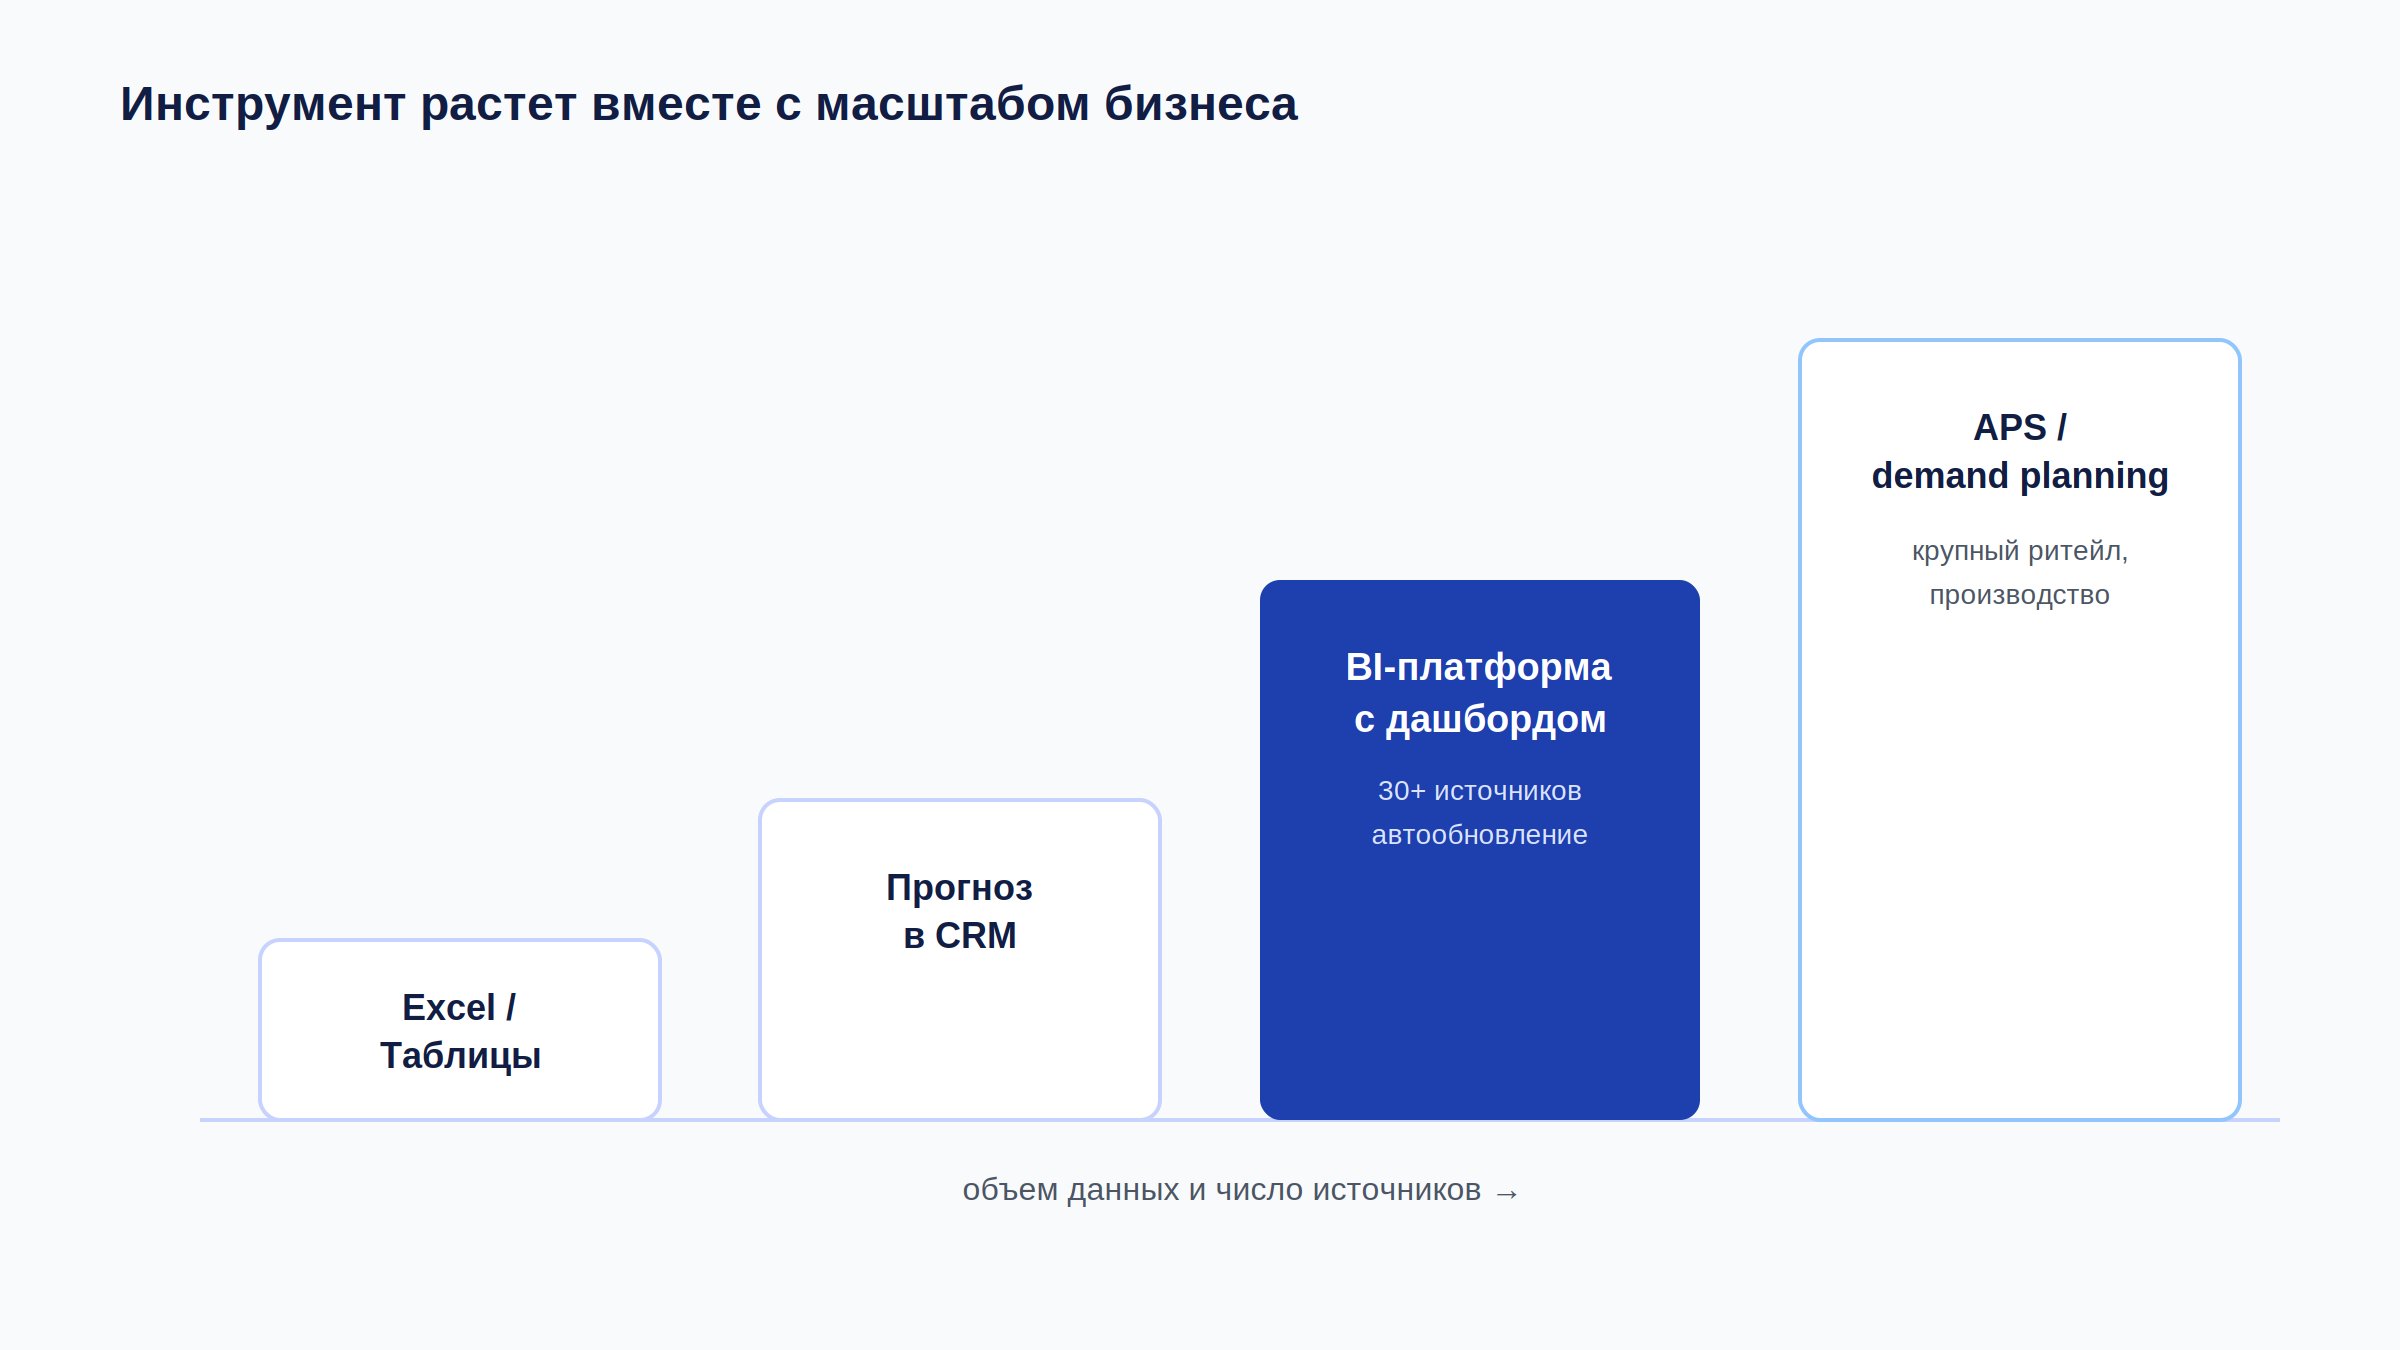
Метод расчета и инструмент, в котором его считают, вопросы разного порядка. Формула сама по себе не требует конкретного софта, но масштаб бизнеса и число источников данных быстро определяют, какой инструмент реально выдержит регулярный пересчет, а какой развалится под собственным весом через несколько месяцев.
Excel и Google Таблицы остаются рабочей точкой входа почти для любого бизнеса. Функции ТЕНДЕНЦИЯ и ПРЕДСКАЗ считают линейную регрессию буквально в одну формулу, скользящее среднее и экспоненциальное сглаживание тоже укладываются в несколько ячеек, а порог входа нулевой: таблица есть у всех. Ограничение проявляется не в формулах, а в масштабе: при росте числа SKU, каналов продаж и источников данных таблица превращается в файл с десятками листов и ссылок между ними, который боится сломаться от одной неверно вставленной строки, а обновление данных остается ручным действием, которое кто-то обязан не забыть сделать вовремя.
Прогноз, встроенный в CRM, решает другую задачу, а не заменяет расчет по историческим продажам. Он оценивает вероятность закрытия сделок по стадиям воронки и неплохо предсказывает выручку на горизонте в один-два месяца, если менеджеры аккуратно ведут пайплайн. Слабое место ровно там же, где и главная ошибка из предыдущего раздела: встроенный CRM-прогноз наследует любую неточность самой воронки и не видит ничего за пределами сделок, ни склад, ни закупки, ни сезонность на уровне товара, поэтому годится как один из источников данных для общего прогноза, но не как единственный.
Специализированные системы планирования спроса, класс APS и demand planning, созданы для крупного ритейла и производства с тысячами SKU и сложной логистикой: они моделируют цепочку поставок целиком, от прогноза спроса до плана производства и распределения по складам. Точность и глубина функциональности у таких систем высокие, но соразмерна цена и сложность внедрения, обычно с отдельной командой и проектом на несколько месяцев, поэтому для среднего бизнеса это редко оправданная инвестиция на старте работы с прогнозом.
BI-платформа с единым дашбордом занимает промежуточную нишу между таблицей и тяжелой специализированной системой. Она подключает данные из разных источников, продажи, маркетинг, склад, финансы, автоматически, без ручной выгрузки в новую таблицу каждую неделю, и строит на этих данных не только отчет по факту, но и прогноз с учетом всех подключенных источников сразу, а не только продаж в отрыве от остального. Для компании, которая переросла Excel по числу источников и SKU, но еще не доросла до отдельного проекта класса APS, это рабочий средний шаг, а не компромисс на скорую руку.
| Инструмент | Для какого объема | Сильная сторона | Слабое место |
|---|---|---|---|
| Excel / Google Таблицы | Малый бизнес, до сотни SKU | Нулевой порог входа, гибкость формул | Ручное обновление, не масштабируется |
| Прогноз внутри CRM | Любой бизнес с воронкой продаж | Видит пайплайн сделок в реальном времени | Не видит склад, закупки, сезонность товара |
| APS / demand planning | Крупный ритейл, производство | Полное моделирование цепочки поставок | Дорого, долгое внедрение |
| BI-платформа с единым дашбордом | Средний бизнес, несколько источников данных | Автоматический сбор данных + AI-прогноз | Требует подключения источников на старте |
Смена инструмента сама по себе не делает прогноз точнее, если метод расчета внутри него неверный или данные на входе грязные. Перенос кривой формулы из таблицы в дорогую BI-платформу даст ту же кривую формулу, только быстрее и на более красивом графике. Инструмент решает вопрос масштаба и автоматизации, а точность по-прежнему определяют метод и дисциплина, с которой компания сверяет прогноз с фактом и пересматривает его при изменении данных, разобранная в предыдущих разделах.
От прогноза к data-driven решениям
Прогноз, даже точный, не создает ценность сам по себе. Он создает ценность только тогда, когда компания реально меняет по нему закупки, бюджет или план, а не просто складывает цифру в архив после совещания. Разрыв между наличием инсайта и действием по нему — это ключевая точка, где теряется большая часть ценности любой data-driven инициативы. Инсайт статичен, пока по нему не начали действовать: компания может уметь отлично считать прогнозы и оставаться посредственной именно в том, чтобы менять по ним решения, а знать и делать, это разные навыки, которые не появляются автоматически друг из друга.
Сам по себе прогноз без контекста тоже мало значит. Технически верная цифра «продажи вырастут на 12% в следующем квартале» ничего не говорит о том, успеют ли поставщики произвести нужный объем, хватит ли оборотных средств на закупку заранее и не упирается ли рост в физический лимит склада. Прогноз становится решением только тогда, когда его читают вместе с остальными ограничениями бизнеса, а не как отдельную цифру на отдельном слайде презентации. Именно поэтому «просто посчитать точный прогноз» почти никогда не решает проблему само по себе: без контекста операций даже правильный вывод легко положить в стол и забыть, если он не совпадает с тем, что руководство планировало делать в любом случае.
Насколько велик этот разрыв на практике, показывает опрос BARC на выборке 697 компаний: 58% респондентов сообщили, что их организации основывают минимум половину регулярных бизнес-решений на интуиции и опыте, а не на данных. При этом у компаний-лидеров опроса доля решений на основе данных доходит до 60%, а у аутсайдеров 70% решений принимается именно на интуиции, прямая связь между долей решений, подкрепленных данными, и конкурентным результатом компании. Дело не в отсутствии данных, дело в привычке ими пользоваться при принятии решения, а не только при подготовке отчета для совета директоров.
Гипотеза, которая кажется очевидной: чем больше данных и дашбордов в компании, тем более data-driven становятся ее решения. Проверка по опросу показывает, что связь работает не так прямолинейно. Компания способна годами накапливать дашборды, отчеты и даже точные прогнозы и при этом продолжать решать половину вопросов на интуиции, потому что между «дашборд существует» и «дашборд смотрят перед решением» лежит организационная привычка, а не техническая возможность. Разница между лидерами и аутсайдерами опроса не в том, у кого больше данных, а в том, кто реально сверяется с ними в момент принятия решения, а не после, когда решение уже принято и данные используют лишь для того, чтобы задним числом его обосновать.
Академическое подтверждение этой связи дает одно из первых крупных эмпирических исследований на тему, работа Brynjolfsson, Hitt и Kim на выборке 179 крупных публичных компаний: фирмы с выраженным data-driven подходом к принятию решений показывают выпуск продукции и производительность на 5-6% выше, чем можно было бы ожидать при их прочих инвестициях и уровне использования IT. Методом инструментальных переменных авторы отдельно показали, что связь не объясняется обратной причинностью, то есть не только успешные компании начинают больше вкладываться в аналитику, а именно сам подход дает измеримый прирост эффективности. Как эти же принципы применяются к конкретным методам анализа данных внутри компании, разобрано в статье про анализ данных для бизнеса.
На практике связка простая: прогноз показывает, что вероятно произойдет, а data-driven культура определяет, изменит ли компания что-то в ответ на эту информацию. Технически верный прогноз, вырванный из контекста возможностей операций и текущих приоритетов руководства, легко проигнорировать или не довести до практичного решения. Куда именно должны стекаться прогноз и остальные данные, чтобы решение по ним принималось быстро, а не через две недели согласований, разобрано в статье про дашборд для бизнеса.
Принятие решений на основе данных: как внедрить в компании
Если разрыв между знанием и действием такой большой, логично спросить, что именно его создает. По ежегодному опросу руководителей NewVantage Partners за 2022 год, 91,9% руководителей, четвертый год подряд, назвали корпоративную культуру, а не технологии, главным препятствием на пути к data-driven результатам, и лишь 8,1% указали на технологические ограничения как первопричину. Это ключевой момент: компания может купить лучшую BI-платформу на рынке и все равно остаться такой же интуитивной в решениях, если никто в организации не отвечает за то, чтобы данные реально использовались.
Данные, которые нужны для решения, часто разбросаны по системам разных отделов: реклама в одном инструменте, продажи в CRM, финансы в учетной системе, и без единого источника, которому доверяют все стороны, отчетность становится фрагментированной, а команды спорят о том, чьи цифры верные, вместо того чтобы обсуждать само решение. Работающая культура данных обычно складывается из трех взаимосвязанных вещей: ценности и нормы, когда данные реально используются, а не декларируются на слайде про миссию компании, управление данными, процессы, которые делают цифры достоверными и доступными, и грамотность работы с данными у сотрудников, которые эти цифры смотрят. Культурный сдвиг происходит только тогда, когда за конкретной метрикой закреплена явная ответственность, а не абстрактное «все отвечают за все», которое на практике означает, что не отвечает никто.
На практике внедрение проще начать с малого, чем сразу пытаться выстроить культуру данных для всей компании. Первый шаг, для каждой ключевой метрики письменно зафиксировать три вещи: что именно она измеряет, откуда берутся исходные цифры и какой источник считается авторитетным, если у двух систем расходятся значения. Второй шаг, назначить конкретного человека ответственным за метрику, не отдел, а именно человека, к которому можно прийти с вопросом. Третий шаг, встроить регулярную сверку прогноза с фактом в существующий ритм совещаний, а не создавать под нее отдельную новую встречу, которую первой отменят при загрузке. Ни один из трех шагов не требует новой платформы или бюджета, и именно поэтому опросы стабильно показывают культуру, а не технологии, главным барьером: софт легко купить, а договориться о том, чья цифра главная, приходится людям внутри компании.
Внедрение культуры данных регулярно спотыкается об одну и ту же ловушку: компания запускает проект «стать data-driven» сразу для всех отделов и всех метрик одновременно, вместо того чтобы для начала навести порядок в одной измеримой цепочке, например прогноз продаж → закупки. Масштабный проект без быстрого первого результата теряет поддержку раньше, чем успевает показать пользу: через несколько месяцев без видимого эффекта энтузиазм угасает, инициативу тихо сворачивают, а компания возвращается к прежним привычкам, но уже с меньшим доверием к самой идее решений на основе данных при следующей попытке. Один доведенный до результата участок работает как доказательство концепции лучше, чем десять параллельно начатых и брошенных на полпути.
Практический рабочий цикл для внедрения выглядит как построй, измерь, научись: команда формулирует гипотезу о поведении рынка или клиентов, строит минимальный тест этой гипотезы, измеряет отклик конкретной метрикой и только потом принимает решение, продолжать в том же направлении или разворачиваться. Этот же принцип из методологии Lean Startup лежит в основе A/B-тестирования: гипотеза формулируется явно и проверяется сравнением метрик между вариантами на статистически надежной выборке, что превращает решение в измеримый результат вместо догадки задним числом. Более широкий обзор того, из чего вообще складывается системная бизнес-аналитика в компании без штатного аналитика, в статье про бизнес-аналитику.
Как ИИ меняет прогнозирование продаж
По данным одного из исследований McKinsey по автономному планированию цепочек поставок, применение ИИ к прогнозированию спроса дает рост выручки до 4%, снижение уровня запасов на 10-20%, снижение затрат на цепочку поставок на 5-10% и повышение точности прогноза на уровне конкретной товарной позиции на 10-12%. Разница не в том, что ИИ считает по какой-то принципиально другой магической формуле, а в том, что он способен одновременно учитывать множество факторов спроса, цену, сезонность, промо-акции, поведение конкурентов, которые вручную свести в одну модель практически невозможно.
Разница начинается уже с того, какие данные модель вообще видит на входе. Классический расчет по формуле обычно опирается на один ряд, историю продаж по месяцам, изредка с ручной поправкой на сезон. ИИ-модель одновременно сопоставляет историю продаж с внешними и внутренними сигналами: погодой для сезонных товаров, ценами конкурентов, календарем акций, остатками на складе, курсом валюты для импортного ассортимента, и находит между ними связи, которые вручную не свести в одну формулу просто из-за количества переменных и их взаимного влияния друг на друга. Человек может удержать в голове два-три фактора одновременно, модель работает с десятками, не теряя из виду ни один.
Вторая практическая разница, скорость обновления. Классический прогноз пересчитывают вручную раз в неделю или месяц, ИИ-модель способна обновлять прогноз по мере поступления новых данных почти в реальном времени и автоматически находить аномалии и неочевидные паттерны, необычные всплески спроса или сбои в цепочке поставок, не дожидаясь, пока их заметит человек за анализом дашборда. По прогнозу аналитической компании Gartner, 70% крупных организаций внедрят ИИ-прогнозирование цепочек поставок для предсказания будущего спроса к 2030 году, направление, которое уже стало рабочим инструментом, а не футуристическим сценарием.
Конкретные задачи, которые в зрелых системах планирования автоматизируются почти полностью, это очистка данных, обнаружение аномалий, генерация базового прогноза и пересчет сценариев при изменении условий. Человеку в этой схеме остается не собирать и не считать, а решать: закупать ли больше товара под найденную аномалию, менять ли цену под предсказанный всплеск спроса, эскалировать ли сбой поставщика раньше, чем он превратится в дефицит на полке. Разница похожа на ту, что уже видна в бизнес-аналитике в целом: система готовит вывод, человек принимает решение с учетом контекста, которого у модели просто нет.
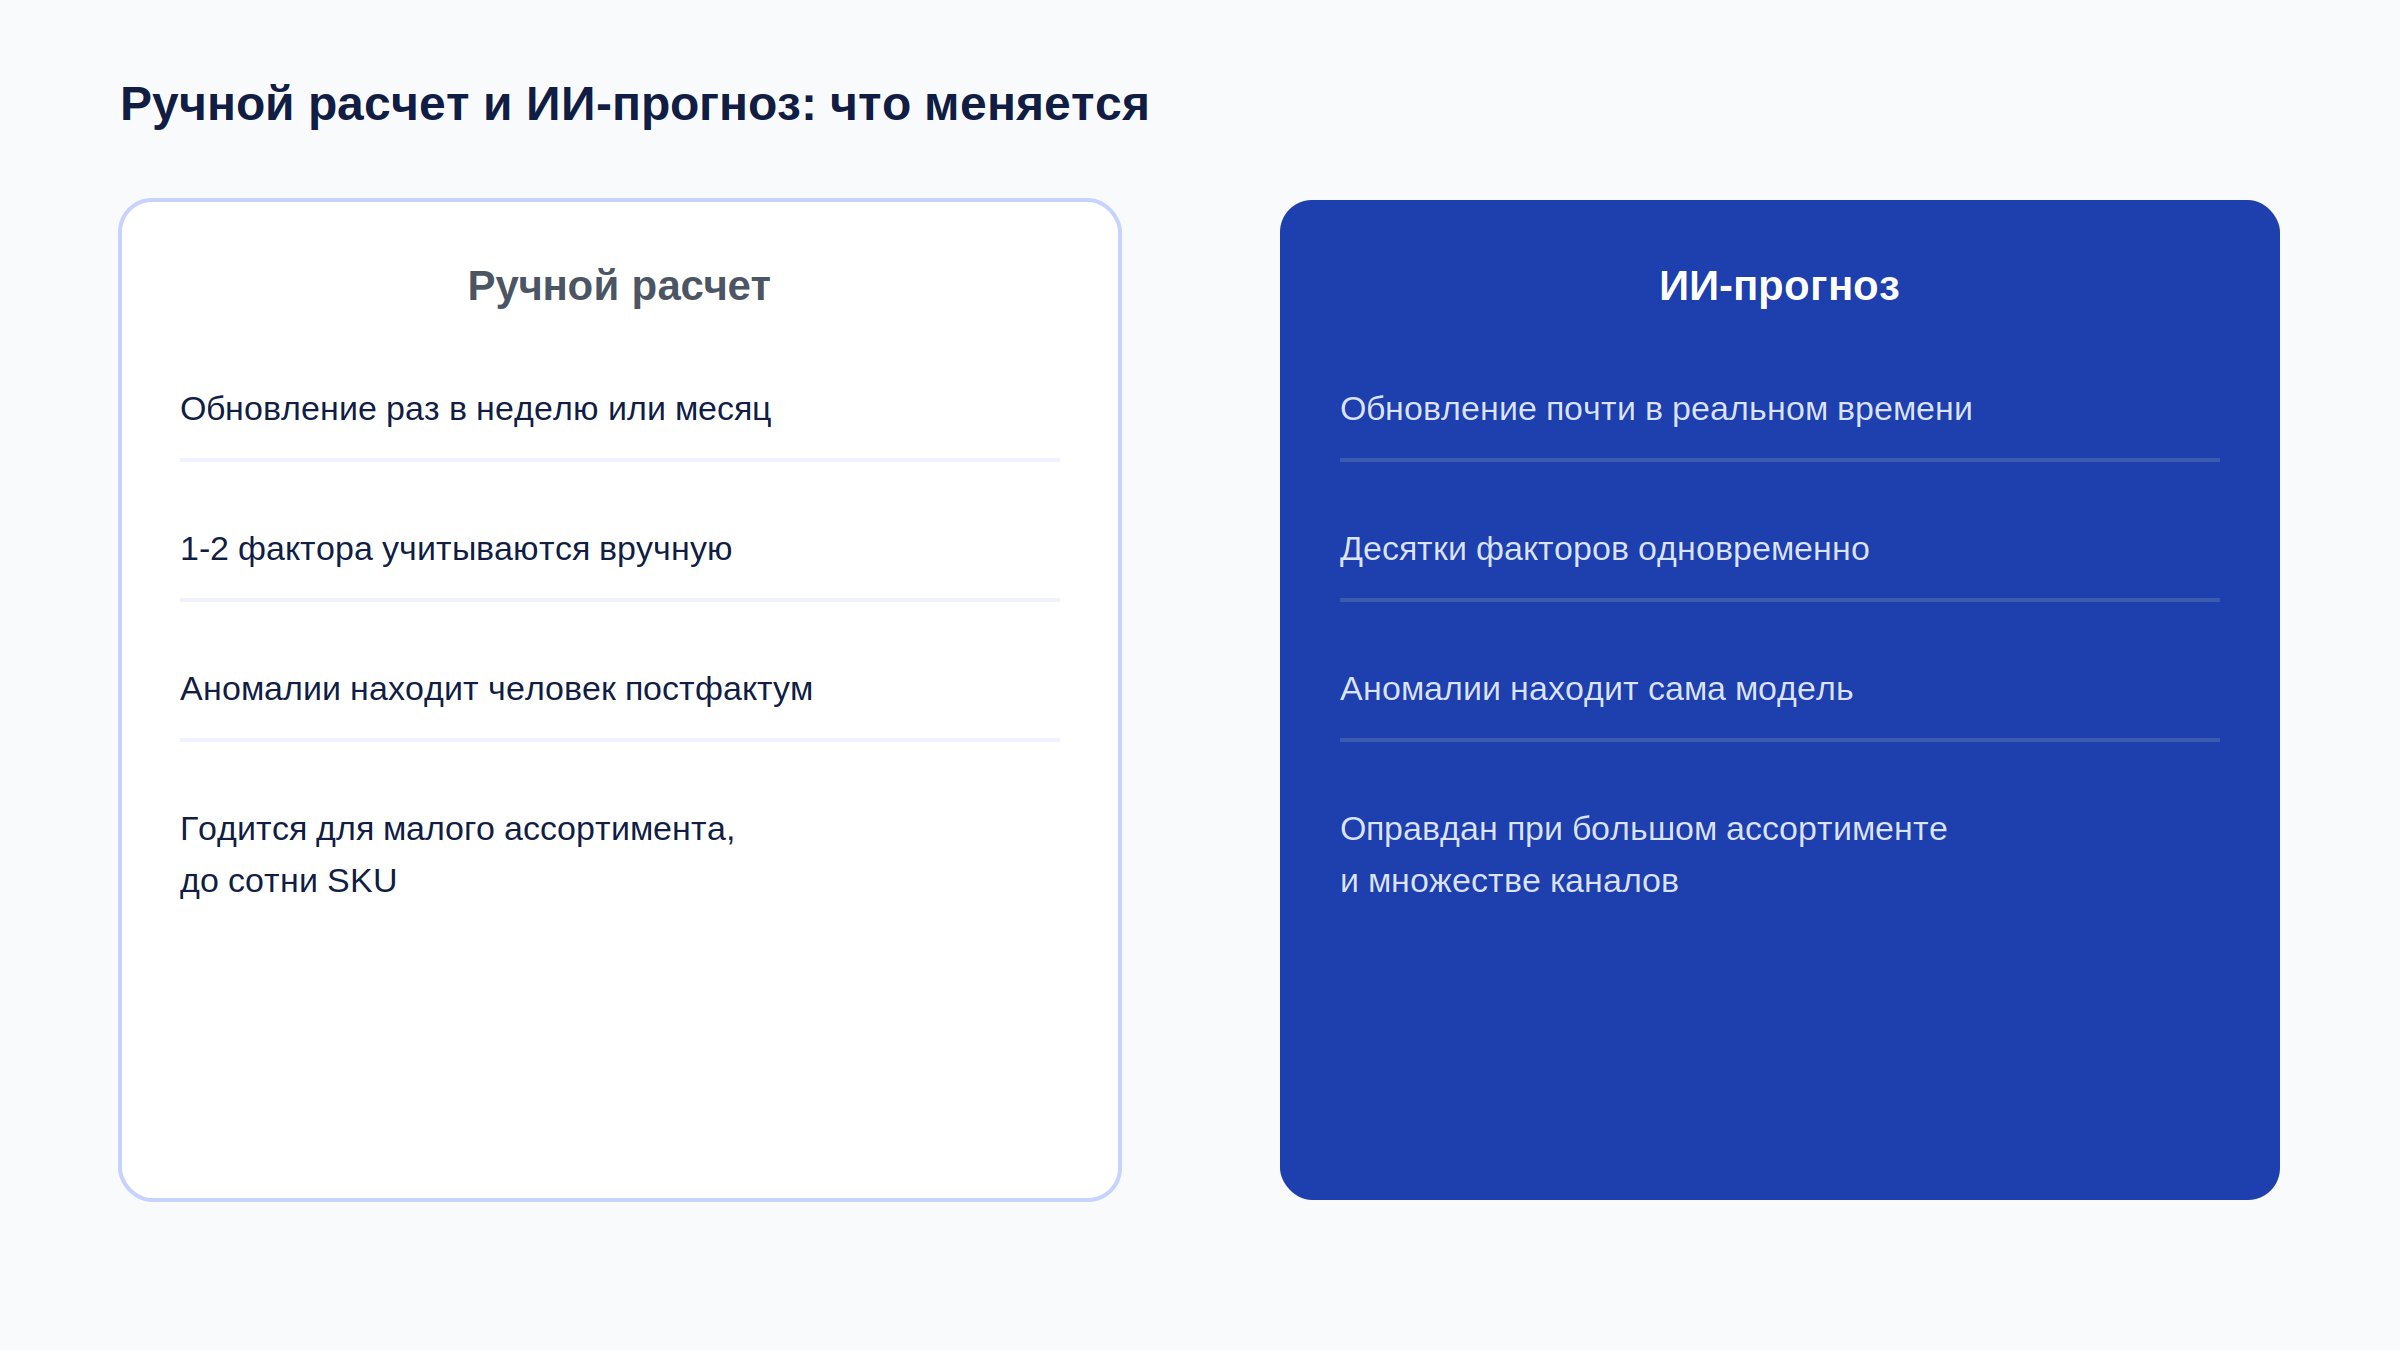
Значит ли это, что малому бизнесу без своего аналитика ИИ-прогнозирование нужно с первого дня. Не всегда. Автоматизация оправдана при большом объеме исторических данных, множестве переменных, много SKU, каналов продаж, точек хранения, и потребности в частом пересчете, именно там ручные и табличные методы перестают справляться с масштабом. Для малого бизнеса с небольшим ассортиментом, ориентир, до сотни SKU, и стабильным, предсказуемым спросом сложность полноценной ИИ-системы избыточна: таблицы остаются рабочим инструментом, особенно на старте бизнеса с ограниченным бюджетом и короткой историей продаж, по которой сложную модель просто не на чем обучить.
Два сигнала надежнее всего показывают, что бизнес перерос таблицы. Первый, устойчиво низкая точность прогноза с постоянными сюрпризами в виде дефицита или излишков, притом что формула вроде бы правильная, а разрыв с фактом не сокращается месяц за месяцем. Второй, ситуация, когда команда тратит на сведение и очистку данных из разных источников больше времени, чем на сам анализ и решения по нему, а таблица Excel уже не файл с формулами, а сложная система, которую боятся трогать, потому что никто до конца не помнит, как она устроена внутри. Единый дашборд Analyzo, который сам находит паттерны и аномалии в данных из 30+ источников и строит прогнозы без ручного сведения таблиц, закрывает именно этот переходный момент, когда таблиц уже не хватает, а нанимать отдельного аналитика еще рано.
Часто задаваемые вопросы
Чем прогноз продаж отличается от плана продаж? План, это цель, которую компания хочет достичь. Прогноз, это расчетная оценка того, что реально произойдет при текущих условиях. План должен опираться на прогноз, но считать и обсуждать их стоит раздельно, иначе прогноз перестает предупреждать о проблемах.
Какой метод прогнозирования выбрать для малого бизнеса? Зависит от объема истории продаж и наличия тренда. При стабильном спросе без выраженного тренда подойдет скользящее среднее или экспоненциальное сглаживание, они считаются в Excel и не требуют много исторических данных. При растущих продажах или сезонности нужен метод, который явно моделирует тренд, линейная регрессия или Хольта-Винтерса, а при большом ассортименте и множестве переменных стоит присмотреться к ИИ-прогнозированию.
Как часто нужно пересматривать прогноз продаж? Единого стандарта нет, частота зависит от волатильности бизнеса и горизонта решений на прогнозе. Рабочий ориентир, короткие еженедельные проверки на уровне сделок или SKU плюс ежемесячный пересмотр итоговой цифры. Общий принцип, пересматривать прогноз при заметном изменении входных данных, а не только по календарю, чисто квартальный пересмотр обычно слишком редкий для быстро меняющегося спроса.
Что такое MAPE в прогнозировании продаж? Средняя абсолютная процентная ошибка, метрика точности прогноза, показывающая среднее отклонение прогноза от факта в процентах. В отличие от MAE она не зависит от масштаба продаж и подходит для сравнения точности между разными товарами и категориями.
С чего начать прогнозирование продаж компании, где раньше его не считали вообще? С одного показателя и одного метода, а не сразу со всей номенклатуры. Возьмите общую выручку за последние 12 месяцев, посчитайте скользящее среднее или экспоненциальное сглаживание, сравните с фактом следующего месяца и посчитайте MAPE. Через два-три цикла станет понятно, отстает ли простой метод от тренда, и тогда есть смысл переходить к регрессии, сезонным индексам или прогнозу по отдельным товарным позициям. Начинать сразу с детального SKU-прогноза без базового навыка сверки прогноза с фактом обычно приводит к тому, что расчет забрасывают раньше, чем он успевает принести пользу.
Data-driven культура, это про инструменты или про людей? Прежде всего про людей и привычки. BI-платформа обеспечивает доступ к данным, но решает не она, а ответственность конкретных людей за то, чтобы решения реально менялись по цифрам, а не оставались красивым дашбордом, на который никто не смотрит между совещаниями.
Когда таблиц в Excel уже недостаточно и пора переходить на BI-платформу? Ориентир, не конкретная цифра выручки, а два сигнала одновременно: точность прогноза стабильно низкая и не растет от месяца к месяцу, и на сведение данных из разных источников уходит больше времени, чем на сам анализ. Если оба сигнала на месте, таблица уже не справляется с масштабом, даже если формулы в ней технически верны.
Что показывают данные
Прогноз ценен не сам по себе, а тем, что меняет решение, закупку, бюджет, план найма. Методы прогнозирования, от скользящего среднего до ИИ-моделей, решают разные по сложности задачи, но ни один из них не работает без привычки регулярно проверять его точность и без готовности компании реально действовать по тому, что показывают цифры. Разрыв между наличием прогноза и data-driven решением на его основе гораздо чаще создает не нехватка метода, а отсутствие места, где прогноз и остальные данные бизнеса сходятся вместе.
Гипотеза, с которой обычно начинают, нам нужен точный прогноз, и тогда решения станут очевидны. Проверка по данным раздела про data-driven культуру показывает иначе: даже точный прогноз бесполезен, если его некому и негде свести с остальными данными бизнеса и превратить в решение за минуты, а не за две недели согласований. Единый дашборд Analyzo подключает данные из 30+ источников, сам строит прогнозы и находит аномалии, так что подключить источники и увидеть цифры можно быстрее, чем свести один отчет по прогнозу вручную за прошлый месяц.