Общий retention компании месяцами держится на уровне тридцати процентов, и на совещании эту цифру читают как стабильность. Разложите ее по когортам, и стабильность часто рассыпается: одна группа клиентов держится на уровне сорока пяти процентов, вторая едва дотягивает до пятнадцати, а усредненная метрика прячет именно то, что нужно чинить в первую очередь. Среднее по всей базе почти никогда не врет буквально, но оно склеивает лучших и худших пользователей в одну цифру и не показывает, где реально теряются деньги.
Продуктовая аналитика существует именно для того, чтобы увидеть эту разницу. Она смотрит не на компанию целиком, а на то, что конкретно происходит внутри продукта: кто до чего дошел, кто вернулся, а кто пропал после первой недели. В статье разберем, чем это отличается от бизнес-аналитики, какие метрики считать и что они означают на практике, как читать когортную таблицу на числовом примере, откуда брать данные и какие ошибки чаще всего обесценивают продуктовые метрики.
Что такое продуктовая аналитика и чем она отличается от бизнес-аналитики
Продуктовая аналитика — это анализ того, как пользователи ведут себя внутри цифрового продукта: какие кнопки нажимают, какие экраны смотрят, до какого шага доходят и на каком отваливаются. Предмет анализа всегда один и тот же уровень: не компания целиком, а конкретный продукт и путь конкретного пользователя в нем.
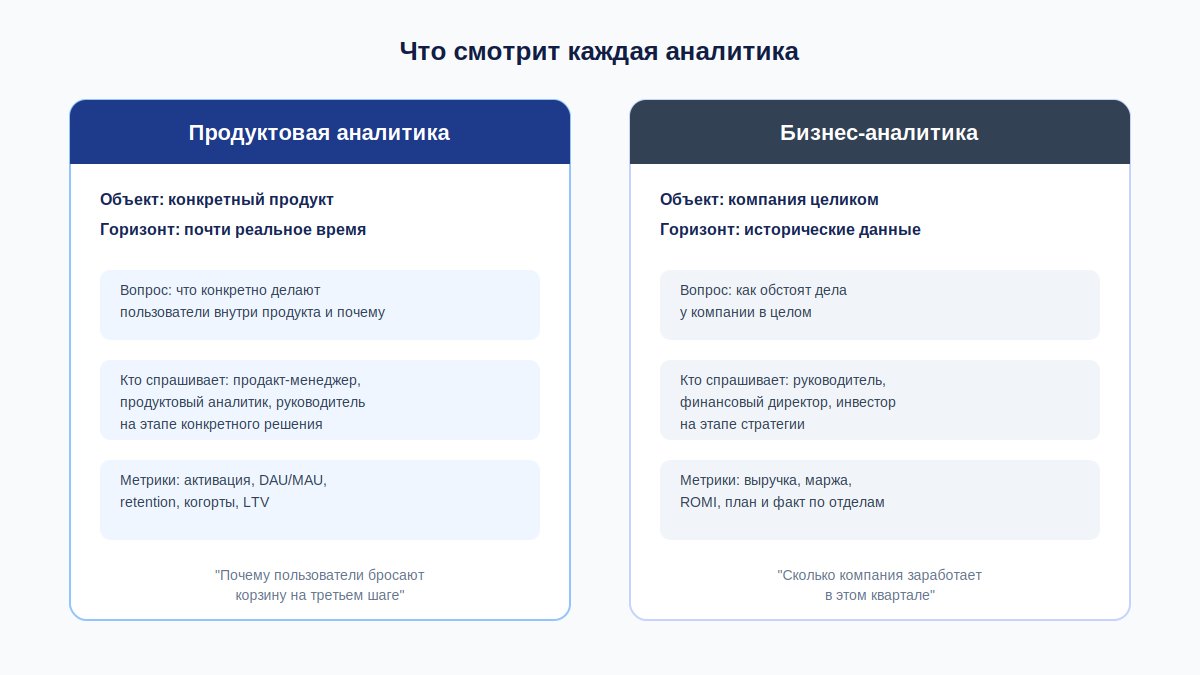
Формальная граница между продуктовой аналитикой и бизнес-аналитикой проходит по двум параметрам сразу. Бизнес-аналитика смотрит на компанию сверху: выручку, отделы, историю сделок за месяцы и годы, и отвечает на вопрос "как вообще идут дела". Продуктовая аналитика смотрит изнутри продукта и почти в реальном времени, и отвечает на другой вопрос: что конкретно делают пользователи и почему они делают именно это, а не что-то другое. Первая нужна, чтобы понять общее состояние бизнеса, вторая, чтобы понять, что менять в самом продукте.
Разница не абстрактная, она видна в том, кто задает вопрос и какой ответ ему нужен. Финансовый директор спрашивает, сколько компания заработает в этом квартале, и ему нужна агрегированная цифра из бизнес-аналитики. Продакт-менеджер спрашивает, почему пользователи бросают корзину на третьем шаге оформления заказа, и здесь общая выручка ничего не скажет, нужна разбивка по шагам конкретного сценария внутри продукта. Обе аналитики работают с одними и теми же людьми и деньгами, но смотрят на них с разного расстояния.
Раньше продуктовой аналитикой занимались только продакт-менеджеры и выделенные продуктовые аналитики, которые глубоко копаются в поведении пользователей и статистике. Там, где такого специалиста в штате нет, эту работу берет на себя сам руководитель с помощью готовых инструментов аналитики, потому что данные о продукте слишком прямо связаны с деньгами, чтобы отдавать их только продуктовой команде. Отток пользователей, брошенные сценарии, невостребованные функции, все это видно в продуктовых данных раньше, чем оно долетит до итогового финансового отчета в виде упавшей выручки.
Здесь же стоит развести продуктовую аналитику и юнит-экономику, потому что оба термина часто путают. Юнит-экономика считает прибыльность одного клиента или сделки в деньгах: сколько стоит привлечь, сколько он принесет за все время. Продуктовая аналитика отвечает на более узкий и более ранний вопрос: почему клиент вообще остается или уходит, глядя на его реальные действия в продукте. Юнит-экономика показывает итоговую цифру, продуктовая аналитика объясняет, из чего эта цифра складывается день за днем. Дальше в статье будет понятно, что эти две вещи не конкурируют, а буквально одна вытекает из другой через метрику удержания.
Зачем продуктовая аналитика нужна бизнесу, а не только продакт-менеджеру
Гипотеза, с которой обычно начинают: продуктовая аналитика, это внутренняя кухня разработки, руководителю о ней знать не обязательно, достаточно смотреть на выручку в конце месяца. Проверка по цифрам показывает обратное. Удержание существующего клиента почти всегда обходится дешевле, чем привлечение нового, и это не абстрактный тезис, а классический вывод из исследования Bain & Company. По расчетам Фредерика Райхельда, рост удержания клиентов всего на пять процентов способен поднять прибыль на двадцать пять и более процентов, хотя сама цифра изначально была получена на данных финансовых услуг и в других отраслях эффект чаще скромнее. Обзор Harvard Business Review отдельно оценивает разрыв в стоимости привлечения и удержания в диапазоне в несколько раз, хотя единого строгого исследования именно для такого диапазона нет, это общеотраслевая оценка, а не точный закон.
За обеими цифрами стоит один и тот же механизм: продукт, в котором пользователь застревает на третьем экране онбординга, теряет клиентов раньше, чем они успевают принести компании хоть какую-то выручку, и никакой маркетинговый бюджет это не компенсирует, потому что дырявое ведро наполняют быстрее, чем оно течет, лишь до определенного предела.
На практике вопрос "зачем нам это" чаще всего звучит от того, кто уже устал разбираться в противоречивых версиях одной и той же цифры. Отдел продаж говорит, что клиенты уходят из-за цены, поддержка говорит, что дело в багах, а продукт настаивает на сложном интерфейсе, и каждый прав ровно настолько, насколько видит свой узкий кусок картины. Продуктовые данные не решают спор автоматически, но дают общую точку отсчета: реальный путь пользователя от регистрации до оттока, на который можно посмотреть всем вместе, а не спорить по ощущениям.
Продуктовые данные напрямую влияют на конкретные управленческие решения, а не остаются красивой аналитикой для отчета.
- Куда вложить бюджет разработки. Если данные показывают, что большинство пользователей отваливается на одном и том же шаге онбординга, а не разбросано по всему продукту, разработку логично сфокусировать именно на этом узком месте, а не распылять команду на десяток мелких улучшений сразу.
- Какую функцию масштабировать, а какую свернуть. Функция, которой пользуется три процента аудитории и которая не влияет на удержание, стоит компании денег на поддержку и усложняет продукт для всех остальных, даже если когда-то казалась хорошей идеей.
- Кого нанимать в первую очередь. Если продуктовые данные показывают провал именно на этапе активации новых пользователей, а не на этапе продаж, следующий найм логичнее в продуктовую команду, а не в отдел продаж, который и так приводит достаточно людей.
- Когда менять цену или тариф. Резкий отток сразу после повышения цены на конкретном тарифе виден в продуктовых данных раньше, чем в квартальном финансовом отчете, и дает время скорректировать решение, а не разбираться с последствиями постфактум.
Без продуктовых данных все четыре решения принимаются на основе интуиции и последнего разговора с клиентом, а интуиция особенно часто ошибается именно там, где решение стоит дорого. Руководитель, который видит только итоговую выручку, реагирует на проблему через месяц после того, как она уже съела часть денег, а руководитель с продуктовыми данными видит первые признаки за недели до того, как это долетит до финансового отчета.
Ключевые продуктовые метрики: от активации до денег
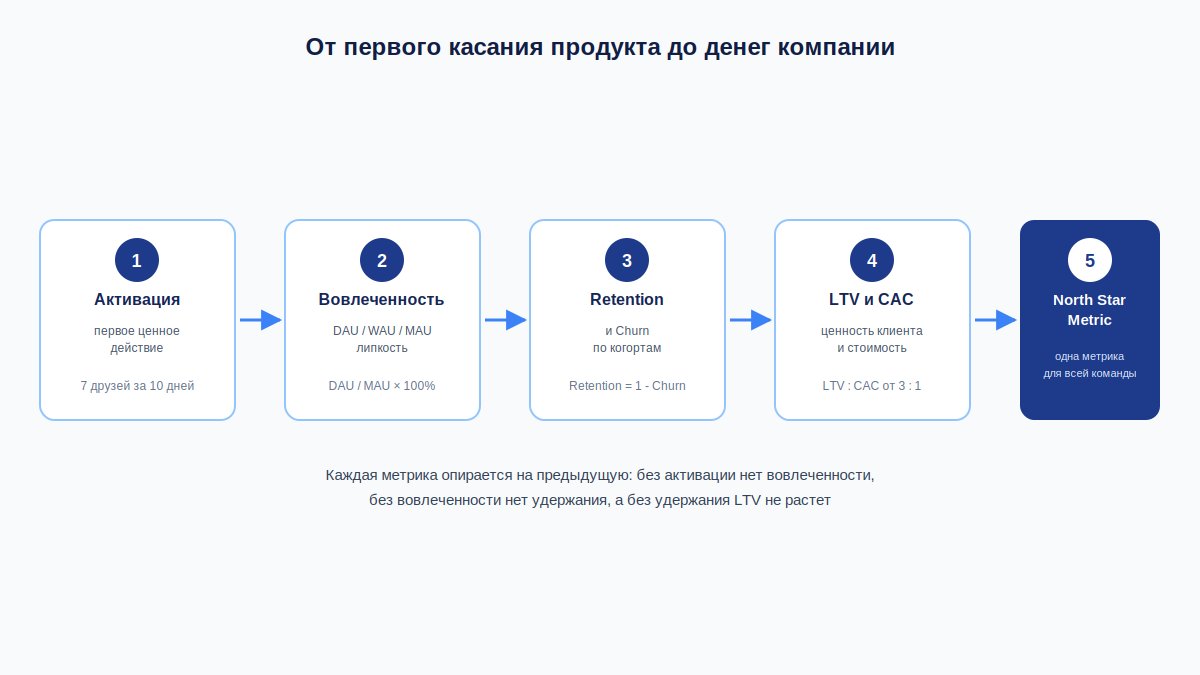
Метрик в продуктовой аналитике десятки, но для управленческого разговора хватает шести-семи, которые выстраиваются в понятную цепочку: от первого касания продукта до денег, которые он приносит компании.
Активация, это не регистрация и не первый вход в продукт, а конкретное действие, которое коррелирует с тем, что пользователь останется надолго. Регистрация показывает только намерение попробовать, а активация показывает, что человек реально получил от продукта пользу, ради которой пришел. У Facebook в первые годы роста такой точкой оказалось добавление семи друзей за десять дней: команда роста выяснила, что пользователи, прошедшие этот порог, оставались активными значительно дольше остальных, и вся дальнейшая работа строилась вокруг именно этого числа, а не вокруг общего роста регистраций.
У Slack похожий порог нашелся на уровне двух тысяч отправленных сообщений внутри команды: по словам основателя компании Стюарта Батерфилда, команда, которая обменялась двумя тысячами сообщений, по-настоящему попробовала продукт, и девяносто три процента таких команд оставались клиентами Slack и дальше. Оба примера показывают одно и то же: у каждого продукта есть свой конкретный порог, а не абстрактное "пользователь освоился".
Дальше идут метрики вовлеченности. DAU, WAU и MAU считают число уникальных активных пользователей за день, неделю и месяц соответственно, а их соотношение показывает, насколько продукт стал ежедневной привычкой, а не разовым визитом. Липкость продукта считают как отношение DAU к MAU: если из ста человек, заходивших в продукт за месяц, в обычный день заходят двадцать, липкость равна двадцати процентам. Ориентир по рынку в целом такой: выше двадцати процентов считается хорошим результатом, выше пятидесяти, показателем мирового класса.
У продуктов, которые становятся ежедневной привычкой вроде мессенджеров и соцсетей, реальные значения обычно заметно выше общего ориентира, и здесь важна оговорка: сравнивать такую метрику имеет смысл внутри одной категории продуктов, а не между приложением для ежедневной переписки и, например, сервисом для подачи налоговой декларации раз в год, у которого низкая липкость это норма, а не проблема.
Retention и churn, зеркальные метрики: churn, доля клиентов, ушедших за период, retention, доля оставшихся. Если отток составляет пять процентов в месяц, удержание равно девяноста пяти. Эта пара метрик напрямую определяет LTV, ценность клиента за все время, потому что чем дольше клиент остается, тем больше денег он успевает принести, и связь здесь не линейная, а значительно более чувствительная к небольшим изменениям оттока, чем кажется на первый взгляд. Возьмем условный пример: продукт с выручкой пятьдесят долларов с клиента в месяц и оттоком пять процентов дает LTV в тысячу долларов. Если снизить отток всего до трех процентов, LTV вырастет примерно до тысячи шестисот шестидесяти семи долларов, рост на две трети без единого нового привлеченного клиента. Работа с удержанием часто дешевле и выгоднее, чем постоянная гонка за новыми лидами, именно из-за этой нелинейности.
LTV и CAC логично рассматривать вместе: CAC, это стоимость привлечения одного клиента, а здоровое соотношение LTV к CAC для зрелого SaaS-бизнеса, по эмпирическому правилу инвестора Дэвида Скока, начинается от трех к одному. Правило именно эмпирическое, выведенное из наблюдений за устоявшимися компаниями, а не строгий математический закон для любой стадии бизнеса: у молодого продукта соотношение может быть ниже, и это не всегда сигнал тревоги. Подробный расчет LTV и CAC на цифрах уже разобран в статье про юнит-экономику, здесь важно другое: оба показателя строятся именно на продуктовых метриках retention и активации, а не берутся откуда-то отдельно.
ARPU, средняя выручка на пользователя, считается просто: вся выручка за период делится на число пользователей. Метрика грубая сама по себе, но полезная как множитель в формуле LTV и как ориентир при сравнении сегментов между собой.
Отдельно стоит North Star Metric, единый показатель, который лучше всего отражает ценность, получаемую пользователем от продукта, и одновременно служит опережающим индикатором роста бизнеса. Смысл в том, чтобы выровнять все команды компании вокруг одной цели вместо десятка разрозненных KPI, которые тянут в разные стороны. В отраслевой практике для этой роли обычно приводят примеры: у Facebook такой метрикой считают число ежедневно активных пользователей, а не число постов, у Airbnb, число забронированных ночей, а не время, проведенное в приложении, у Spotify, время прослушивания музыки, а не количество подписчиков. Три примера объединяет одно: North Star Metric всегда завязана на реальную пользу для пользователя, а не на активность саму по себе.
Набор приоритетных метрик из этого списка отличается по типу бизнеса, и это стоит учитывать, прежде чем копировать чужой дашборд один в один. У SaaS-продукта с подпиской на первом месте retention и LTV, потому что выручка растягивается на месяцы вперед и зависит именно от того, как долго клиент остается. У маркетплейса или интернет-магазина важнее частота повторных покупок и средний чек за визит, а месячный отток не всегда применим напрямую, потому что у разовой покупки нет подписки, которую можно отменить. У мобильного приложения с бесплатным доступом на первый план выходит активация и стикинес, потому что монетизация чаще всего идет от вовлеченности, а не от прямой оплаты за вход. Продуктовая аналитика не работает по одному универсальному шаблону метрик, она подбирается под то, как именно бизнес зарабатывает деньги.
Собрать все метрики в одну таблицу полезно именно для управленческого разговора, чтобы не путать, какая цифра о чем говорит и на какое решение бизнеса она влияет.
| Метрика | Что показывает | Формула | На что влияет в бизнесе |
|---|---|---|---|
| Активация | Дошел ли пользователь до первой реальной пользы | Доля выполнивших ключевое действие от всех зарегистрированных | Сколько лидов вообще превращается в реальных пользователей |
| DAU / WAU / MAU | Сколько людей активны за день, неделю, месяц | Число уникальных активных пользователей за период | Масштаб реального использования продукта |
| Липкость (stickiness) | Стал ли продукт ежедневной привычкой | DAU / MAU × 100% | Устойчивость спроса без постоянного напоминания рекламой |
| Churn / Retention | Доля ушедших и доля оставшихся клиентов | Churn = ушедшие / клиенты на начало периода | Скорость, с которой утекает уже оплаченная база |
| LTV | Сколько денег принесет клиент за все время | ARPU / Churn (упрощенно) | Сколько разумно тратить на привлечение и удержание |
| CAC и LTV к CAC | Окупается ли привлечение клиента | LTV / CAC, ориентир от 3 к 1 | Здоровье модели роста, не тратит ли компания больше, чем зарабатывает |
| ARPU | Средняя выручка на одного пользователя | Выручка / число пользователей за период | Множитель для LTV и сравнения сегментов |
| North Star Metric | Единый показатель пользы продукта для пользователя | Своя для каждого продукта | Выравнивает все команды вокруг одной цели вместо разрозненных KPI |
Когортный анализ: как разделить пользователей на когорты и что это дает
Когорта, это группа пользователей с общим стартовым признаком, чаще всего датой регистрации, которую отслеживают во времени. Отличие от простого сегмента принципиальное: сегмент, это снимок в один момент, а когорта следит за одной и той же группой людей на протяжении нескольких периодов подряд. Общий retention по всей базе, это среднее значение, а средние иногда врут: они смешивают лучших пользователей с худшими и прячут именно то, на что нужно реагировать в первую очередь, а именно какие группы реально остаются, а какие уходят. Ровно этот эффект был в примере из начала статьи, где усредненные тридцать процентов оказались смесью двух совсем разных картин.
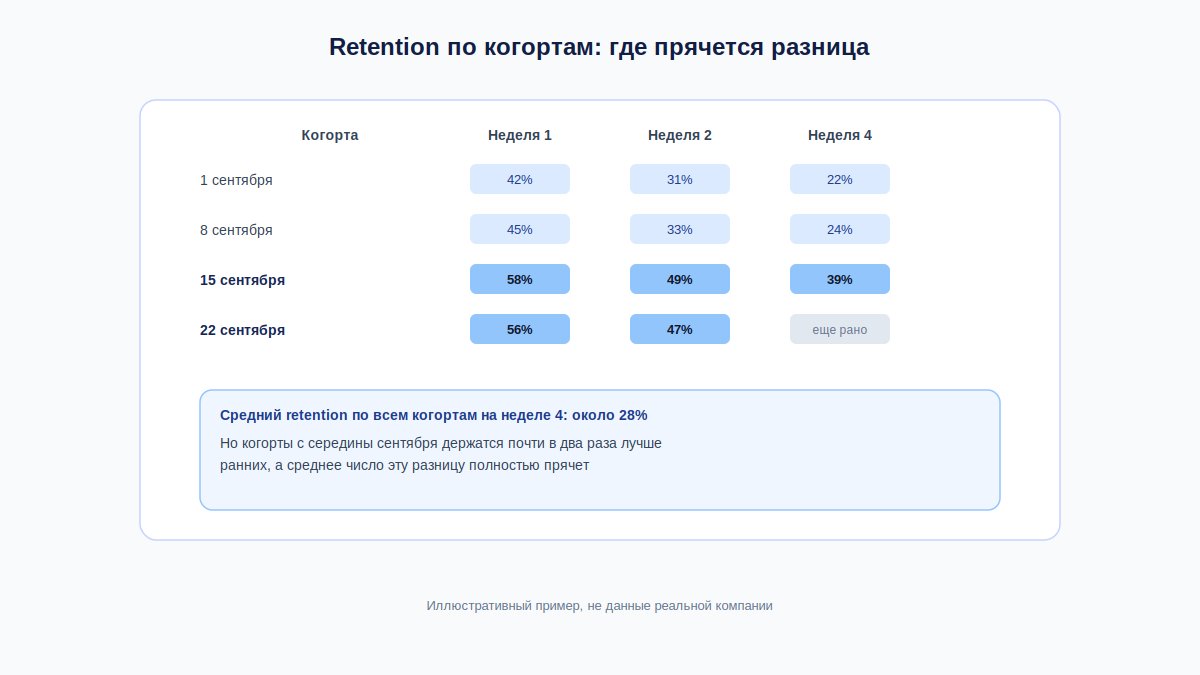
Разберем на числовом иллюстративном примере, как это выглядит на практике. Условный продукт привлекает пользователей каждую неделю, и когортная таблица показывает, какая доля каждой недельной группы остается активной спустя одну, две и четыре недели после старта.
| Когорта (неделя регистрации) | Неделя 0 | Неделя 1 | Неделя 2 | Неделя 4 |
|---|---|---|---|---|
| 1 сентября | 100% | 42% | 31% | 22% |
| 8 сентября | 100% | 45% | 33% | 24% |
| 15 сентября | 100% | 58% | 49% | 39% |
| 22 сентября | 100% | 56% | 47% | еще рано |
По строкам видно, как каждая когорта затухает со временем, это нормально и происходит с любым продуктом. Интереснее читать таблицу по столбцам: на неделе четыре первые две когорты держатся на уровне двадцати с небольшим процентов, а когорты с середины сентября, почти в два раза лучше. Если бы этот продукт смотрел только на средний retention по всей базе, разница осталась бы незаметной, а именно она и есть сигнал: что-то изменилось в привлечении или в первых днях знакомства с продуктом в середине месяца, и это стоит найти и повторить, а не списывать на случайные колебания.
Числа в примере иллюстративные, а не данные конкретной компании, но их порядок соответствует реальным отраслевым бенчмаркам. По данным Amplitude, полученным на анализе более двух с половиной тысяч компаний, если на седьмой день в продукте остается активными от семи процентов исходной когорты, продукт уже попадает в топ-четверть по эффективности активации. По данным Pendo, программные продукты в среднем удерживают около сорока процентов пользователей через месяц после привлечения и около тридцати процентов через три месяца. Обе цифры собственные бенчмарки вендоров без независимой внешней проверки, поэтому к ним стоит относиться как к ориентиру для сравнения, а не как к универсальному стандарту, обязательному для любого продукта.
По когортной таблице удержания можно прикинуть и LTV каждой когорты, не дожидаясь, пока клиенты действительно уйдут. Логика простая: берется средняя выручка на пользователя за период и умножается на retention этого периода, а результаты по всем периодам складываются. Клиент, который уже отвалился, физически не может принести компании выручку в следующем периоде, поэтому кривая LTV когорты всегда идет следом за кривой удержания, а не существует отдельно от нее. Если когорта из ста клиентов при ARPU в тысячу рублей удерживает шестьдесят человек через месяц и сорок пять через два, ожидаемая выручка когорты за первые два месяца это сто тысяч рублей в первом плюс шестьдесят тысяч во втором, а не двести тысяч, как получилось бы при наивном расчете без поправки на отток.
Что делать, когда одна когорта заметно хуже остальных, зависит от того, что конкретно изменилось в период ее старта: новый канал привлечения, измененный онбординг, сезонный всплеск случайных пользователей, которые никогда всерьез не собирались продуктом пользоваться. Проверка простая: сравнить состав отстающей когорты с остальными по источнику трафика и по тому, какой шаг онбординга они проходили, а не сразу переписывать продукт целиком. Часто причина находится в одном канале или в одном экране, а не во всем продукте сразу, и чинить стоит именно ее, а не запускать масштабный редизайн ради проблемы одной недели.
Как собирать данные для продуктовой аналитики
Продуктовую аналитику строят на событиях, а не на итоговых отчетах, и обычно события делят на пять групп: события активации, регистрация, подтверждение почты, завершение онбординга, первое использование ключевой функции; события вовлеченности, клики, поисковые запросы, просмотры контента; события монетизации, просмотр тарифов, начало пробного периода, оплата, продление подписки; события удержания, частота входов, возврат после паузы; и события ошибок, неудачные оплаты, сбои формы, таймауты. Каждое событие технически несет имя, метку времени, идентификатор пользователя и контекст: с какого устройства, из какого канала, в рамках какого сценария.
На практике данные собирают тремя способами, и большинство компаний по ходу роста проходят все три по очереди. Первый способ, это собственный трекинг в коде: например, JavaScript-событие в Яндекс.Метрике, которое разработчик вручную вызывает при клике по кнопке, отправке формы или просмотре видео. Способ гибкий, но требует постоянной ручной работы программиста на каждое новое событие. Второй способ, готовые сервисы продуктовой аналитики вроде Amplitude или Mixpanel, которые собирают и анализируют именно поведение внутри конкретного продукта через SDK. Третий способ, единая система сбора данных, которая один раз получает событие и раздает его сразу во все нужные инструменты, аналитику, маркетинг, CRM, вместо того чтобы заводить одно и то же событие отдельно в каждой системе.
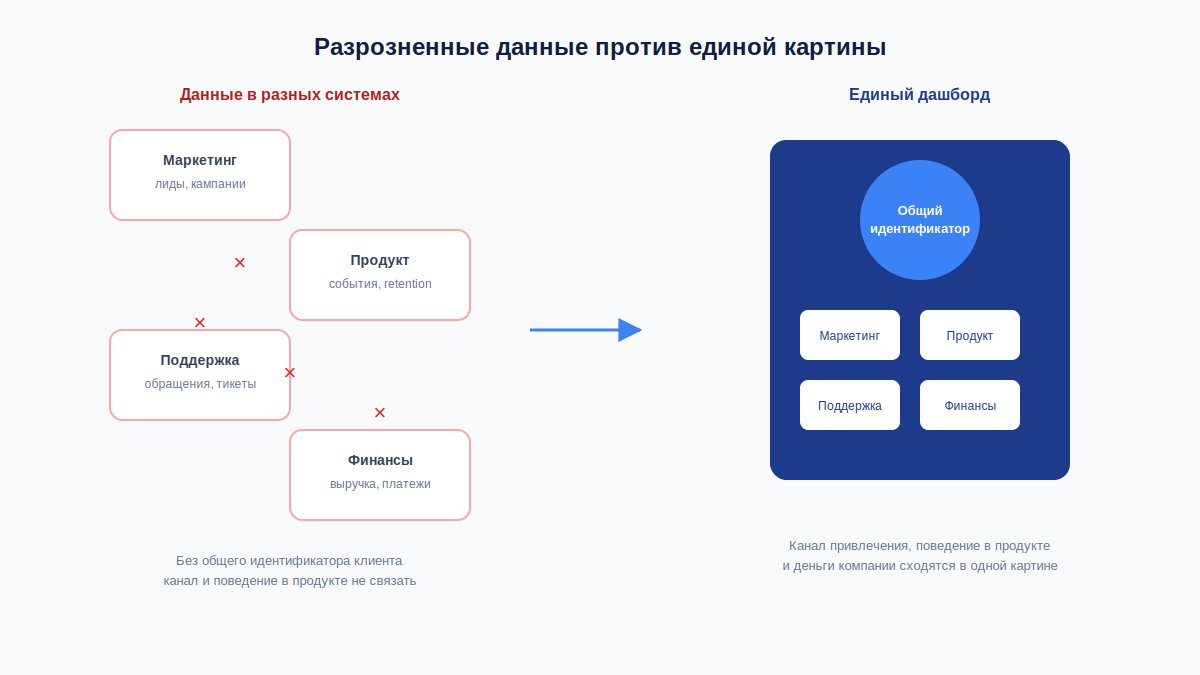
Третий способ решает проблему, с которой рано или поздно сталкивается любая растущая компания: разрозненные данные, которые физически невозможно свести вместе. Маркетинг ведет лиды и рекламные кампании в одной системе, продуктовая команда отслеживает поведение в приложении в другой, и если у инструментов нет общих идентификаторов пользователя, связать канал привлечения с тем, что человек реально делает в продукте, попросту нельзя.
Та же проблема бьет и по расчету оттока: команда поддержки хочет заранее знать, кто из клиентов рискует уйти, но продукт владеет одними данными, поддержка другими, а маркетинг третьими, и без единого владельца общей картины никто не берет на себя ответственность собрать все вместе. По некоторым оценкам, до двух третей данных, которые в принципе доступны компаниям, вообще не доходят до анализа, просто потому что лежат в разных системах и никто не сводит их в одну картину.
Какие именно события логировать в первую очередь, тоже зависит от типа продукта. У SaaS-сервиса критичны события внутри рабочего процесса: создание проекта, приглашение коллеги, использование ключевой функции, потому что именно они обычно ведут к активации и удержанию. У интернет-магазина в приоритете события воронки покупки: просмотр товара, добавление в корзину, оформление заказа, отказ на конкретном шаге, потому что там теряются деньги здесь и сейчас. Пытаться логировать сразу все возможные события с первого дня, обычная ошибка растущей команды: данных становится много, а разобраться, какие из них действительно влияют на решения, сложнее, чем если бы событий было в разы меньше, но выбраны они осознанно под конкретные вопросы бизнеса.
Именно здесь сквозная аналитика решает задачу на уровне архитектуры данных, а не отдельного отчета: она сводит события из разных источников по общему идентификатору клиента, и только после этого продуктовые метрики вроде retention можно честно связать с деньгами, которые клиент в итоге принес компании.
Типичные ошибки продуктовой аналитики
Даже когда данные собраны правильно, их легко обесценить неверной интерпретацией. Вот четыре ошибки, которые встречаются чаще остальных.
- Переизбыток метрик без ясной цели. Метрика тщеславия, это показатель, который выглядит впечатляюще, но не меняет ни одного решения: общее число регистраций, суммарные скачивания, просмотры страниц. Такие цифры почти всегда растут и красиво смотрятся в презентации для совета директоров, но не привязаны ни к одному рычагу, которым реально управляет команда. Когда на разных дашбордах одновременно отслеживают по три-четыре десятка показателей, команда тратит больше времени на просмотр отчетов, чем на решения по ним, а действительно важные цифры тонут среди второстепенных.
- Смотреть на средние показатели вместо когорт и сегментов. Тот же эффект, что уже разобран в разделе про когорты: смешанный retention всех пользователей сразу, и платящих, и бесплатных, вводит в заблуждение, потому что платящие используют продукт заметно активнее, и на фоне общей усредненной цифры реальная активность и потенциал бесплатных пользователей остаются незаметными. Любая метрика, посчитанная одним числом на всю базу без разбивки по сегментам, рискует спрятать именно ту проблему, ради которой ее вообще считали.
- Считать продуктовые метрики в отрыве от денег компании. Вовлеченность сама по себе, число сессий, глубина скролла, ничего не говорит о здоровье бизнеса, если ее не связать с retention и LTV. Метрика, которая растет, но не тянет за собой удержание или выручку, скорее украшает презентацию, чем помогает принять решение, и разрозненные данные из раздела выше только усиливают этот риск: без единой картины метрику вовлеченности физически не с чем сопоставить.
- Путать корреляцию активности с причиной роста выручки. Классический документированный пример, поисковая реклама eBay: в две тысячи двенадцатом году компания тратила десятки миллионов долларов на рекламу по запросам со своим брендом, будучи уверена, что именно эта реклама двигает продажи. Крупный полевой эксперимент показал обратное: девяносто девять с половиной процента трафика, который якобы приходил по рекламе, все равно пришел бы на сайт органически. Показ рекламы и покупка оказались следствием одного и того же третьего фактора, намерения пользователя купить, а не причиной друг друга. В продуктовой аналитике эта же ловушка встречается регулярно: команда видит, что активные пользователи определенной функции чаще покупают, и делает вывод, что функция увеличивает продажи, хотя возможна и обратная логика, продукт просто привлекает функцией уже заинтересованных покупателей.
Гипотезу стоит формулировать до того, как посмотреть на данные, а не подгонять объяснение под уже увиденную цифру. Если кажется, что дело в конкретной функции или конкретном канале, разумный следующий шаг, проверить это на контрольной группе или хотя бы на когорте, где переменная отличается, а не сразу считать совпадение доказательством.
Продуктовая аналитика в едином дашборде: без Excel и самописных SQL-отчетов
Проблема, которая прошла через весь этот текст в разных формах, одна и та же: продуктовые метрики живут отдельно от денег компании. DAU считают в одном сервисе, retention в другом, а выручку и CAC, в третьей системе, которую ведет финансовый отдел. Руководитель видит три разные картины и вынужден сводить их в голове самостоятельно, обычно уже постфактум, когда проблема успела обойтись компании дороже, чем если бы ее заметили на неделю раньше.
В едином дашборде Analyzo продуктовые метрики стоят рядом с воронкой продаж и финансовым результатом, а не в отдельной вкладке отдельного сервиса. Когда retention конкретной когорты падает, это видно сразу рядом с тем, как это отражается на выручке и на стоимости привлечения по тому же каналу, а не после того, как аналитик вручную сведет три экспортированных таблицы в четвертую. AI ищет отклонения по каждому срезу данных сам: если retention у пользователей из одного канала внезапно просел на пять процентных пунктов, дашборд подсвечивает это как аномалию, а не ждет, пока кто-то заметит разницу, листая отчеты вручную раз в месяц.
Переход от Excel и самописных SQL-запросов к единому дашборду обычно происходит не по расписанию, а в конкретный момент: когда сведение данных из разных источников начинает отнимать больше времени, чем сам анализ, ради которого эти данные вообще собирают. До этого момента таблица еще справляется, после, каждая новая метрика требует новой ручной сверки, и команда тратит часы там, где могла бы смотреть на готовую цифру.
Типичный путь роста выглядит одинаково почти у любой компании: сначала один график в Excel по одному источнику, дальше несколько вкладок, которые кто-то сводит руками по вечерам, а затем либо нанимают аналитика под отдельный BI-инструмент, либо подключают готовую платформу, которая берет расчет метрик и поиск аномалий на себя. Момент перехода определяет не выручка компании и не число сотрудников, а именно это соотношение: сколько часов уходит на сведение цифр против того, сколько времени остается на решения по ним.
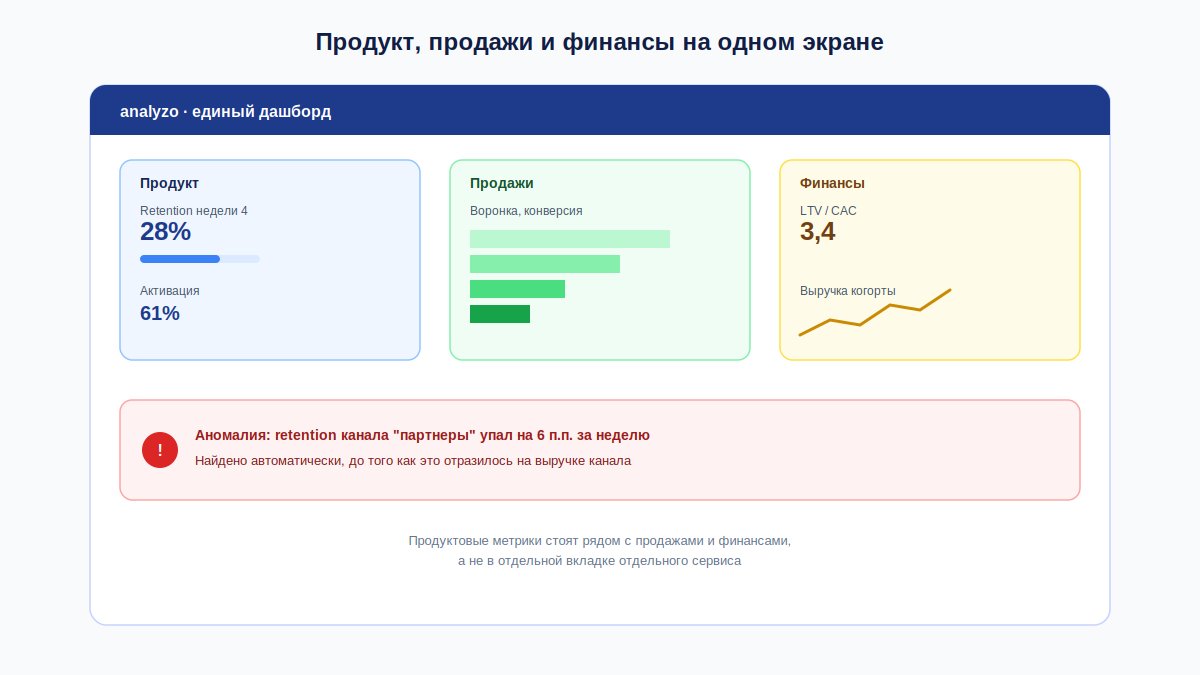
Визуализация продуктовых метрик на таком дашборде решает и вторую половину задачи: retention по когортам, о котором шла речь выше, читается быстрее в виде тепловой карты или графика, чем в виде голой таблицы процентов, особенно когда когорт становится больше четырех.
Часто задаваемые вопросы
Чем продуктовая аналитика отличается от бизнес-аналитики? Продуктовая аналитика смотрит на поведение пользователей внутри конкретного продукта почти в реальном времени, бизнес-аналитика смотрит на компанию целиком через исторические агрегированные данные. Первая отвечает на вопрос, что делают пользователи и почему, вторая, как обстоят дела у компании в целом.
Чем занимается продуктовая аналитика на практике? Она отслеживает путь пользователя от первого касания продукта до устойчивого использования: активацию, вовлеченность, удержание, отток, и переводит эти метрики в деньги через LTV и CAC. На выходе, конкретные решения: куда вкладывать бюджет разработки, какую функцию масштабировать, а какую свернуть.
Нужна ли продуктовая аналитика небольшой компании без штатного аналитика? Да, если у продукта есть регистрация и повторное использование. Начинать не обязательно с полного набора метрик: активации и retention по когортам обычно достаточно, чтобы увидеть главную проблему, а остальные метрики добавляются по мере роста продукта.
Какой инструмент выбрать для продуктовой аналитики: Excel, отдельный сервис или единый дашборд? Зависит от масштаба. Один источник данных и разовый отчет, Excel справится. Несколько источников и нужен регулярный мониторинг, отдельный сервис вроде Amplitude или Mixpanel. Когда продуктовые метрики нужно постоянно сопоставлять с продажами и финансами, эффективнее единый дашборд, который сводит источники сам.
Как часто нужно пересматривать продуктовые метрики? Retention и когортный анализ имеет смысл смотреть не реже раза в месяц, чтобы вовремя заметить, что новая когорта ведет себя иначе, чем предыдущие. Активацию и вовлеченность полезно отслеживать чаще, особенно после любых изменений в онбординге или интерфейсе, чтобы увидеть эффект изменения, пока его легко связать с конкретной причиной.
Сколько метрик реально нужно отслеживать одновременно? Для управленческого дашборда обычно хватает пяти-семи метрик из цепочки активация, вовлеченность, retention, LTV. Остальное, это метрики для рабочих гипотез конкретной команды, их держат отдельно и не выносят на общий экран руководителя, иначе срабатывает та же ошибка переизбытка метрик, о которой шла речь выше.
Можно ли строить продуктовую аналитику без выделенного продуктового аналитика в штате? Можно, если начать с малого: одной активации и retention по когортам вместо попытки сразу настроить полный набор метрик и дашбордов. Готовые инструменты и единый дашборд берут на себя расчеты и поиск аномалий, а роль руководителя в этом случае, регулярно смотреть на цифры и реально менять решения по ним, а не только настроить сбор данных и забыть.
Что показывают данные
Продуктовая аналитика не отдельная дисциплина для продакт-менеджера, а часть общей картины бизнеса, которая обязана сходиться с деньгами компании, а не жить в своей вкладке отдельного сервиса. Активация запускает цепочку, вовлеченность держит пользователя внутри продукта, retention определяет, как долго он остается, а через LTV эта цепочка выходит на выручку, которую видит уже финансовый директор.
Если в своих данных пока непонятно, с чего начать, первый шаг простой: разбейте текущий retention по когортам за последние два-три месяца и сравните их между собой, а не с общим средним. Разница между лучшей и худшей когортой обычно и есть ответ на вопрос, что чинить в первую очередь.
Единый дашборд Analyzo сводит продуктовые метрики с данными продаж и финансов в одном месте и сам находит отклонения по когортам и сегментам, так что подключить источники и увидеть реальную картину можно быстрее, чем свести один такой отчет вручную.